
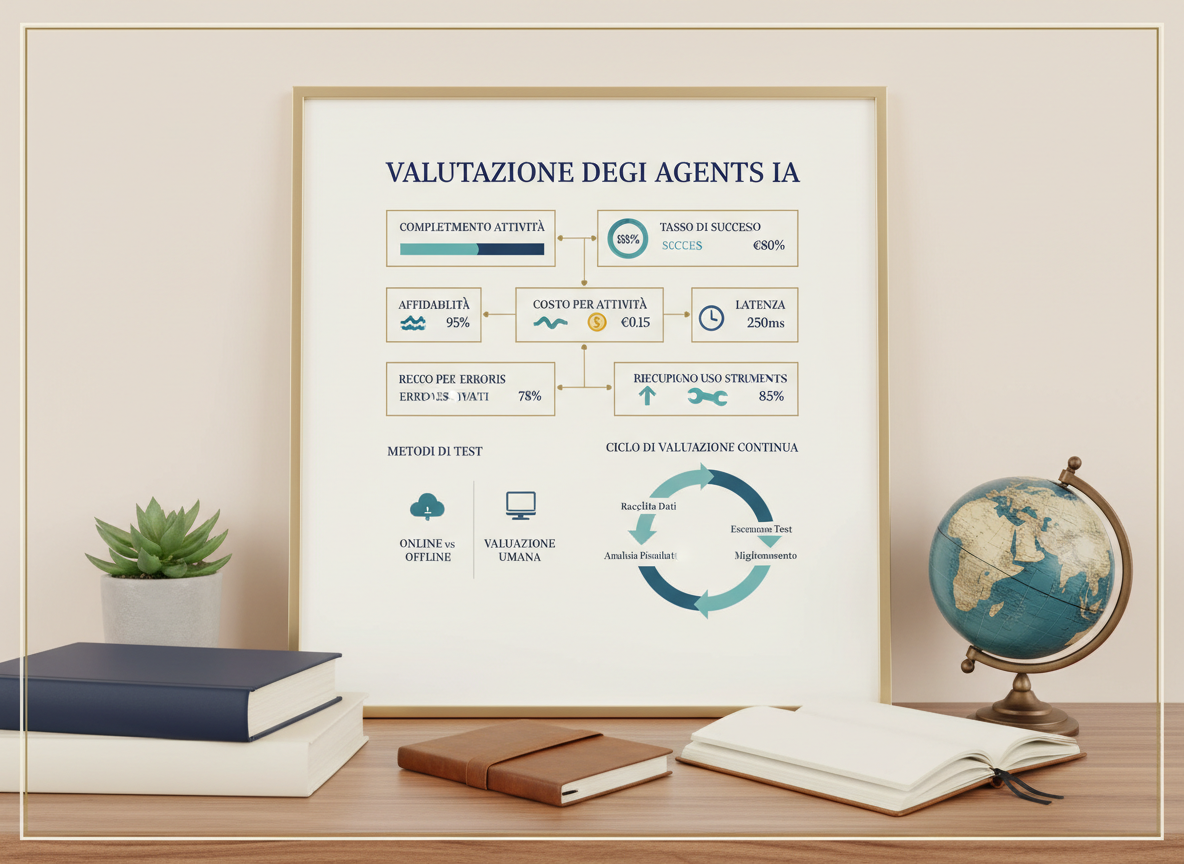
Valutare un modello linguistico è già difficile. Valutare un agente lo è molto di più. Un modello produce una risposta; un agente esegue un processo: pianifica, usa strumenti, modifica lo stato, può fallire a metà percorso, recuperare, riprovare e arrivare comunque a un risultato corretto.
Per questo una singola metrica non basta. Se guardiamo soltanto l’output finale rischiamo di ignorare costi, latenza, instabilità e comportamenti pericolosi. Se guardiamo soltanto i passi intermedi rischiamo invece di penalizzare strategie diverse ma ugualmente efficaci.
In breve
- la metrica centrale resta il task completion rate, ma va definita con precisione;
- contano anche affidabilità, costo, latenza, numero di passi ed error recovery;
- bisogna misurare la varianza tra esecuzioni, non soltanto la media;
- le eval devono includere casi normali, edge case e failure intenzionalmente introdotti;
- una valutazione seria combina test offline, test online e osservabilità in produzione.

La domanda fondamentale: ha completato davvero il compito?
La prima metrica è apparentemente semplice: il task è stato completato? Ma già qui emerge un problema. Che cosa significa “completato”?
Un agente che deve prenotare un ristorante può trovare un locale adatto ma non finalizzare la prenotazione. Un agente che deve analizzare cento documenti può elaborarne novantanove correttamente e saltarne uno. Un agente che deve generare un report può produrre il documento, ma con un dato chiave errato.
Serve quindi una definizione operativa del successo. In molti casi è utile distinguere tra successo completo, successo parziale, fallimento recuperabile e fallimento critico.
Una funzione di utilità, non una classifica assoluta
Due agenti possono completare lo stesso numero di task ma con costi e tempi molto diversi. Possiamo pensare a una funzione di utilità complessiva:
U = w₁Q + w₂R − w₃C − w₄L − w₅E
- Q = qualità del risultato;
- R = affidabilità;
- C = costo;
- L = latenza;
- E = gravità degli errori.
I pesi dipendono dal contesto. In un processo interno a basso rischio il costo può pesare molto. In un processo amministrativo o sanitario, la gravità degli errori può dominare tutte le altre metriche.
Affidabilità: la media non basta
Supponiamo che un agente riesca nel 90% dei casi. Il numero sembra buono, ma nasconde almeno tre domande: fallisce sempre sugli stessi casi? I fallimenti sono casuali o sistematici? Quanto sono gravi?
Un sistema che sbaglia raramente ma in modo catastrofico può essere peggiore di un sistema che fallisce più spesso ma sempre in modo controllato. Per questo è importante classificare gli errori: benigni, recuperabili, silenziosi, irreversibili.
Conta anche la varianza tra run. Un agente non deterministico può completare lo stesso task in tre modi diversi. Se una esecuzione costa dieci volte più delle altre, o utilizza un tool non previsto, il comportamento è operativamente instabile anche se il risultato finale è corretto.
Costo: misurare il task, non il token
Il costo per milione di token è utile per confrontare modelli, ma è spesso una metrica insufficiente per gli agenti. Un agente può effettuare molte chiamate al modello, interrogare motori di ricerca, database e API esterne, generare retry e passare a modelli più costosi in fallback.
La metrica più utile è quindi il costo per task completato. Ancora meglio: costo medio, mediana e percentili. Una coda di task molto costosi può incidere pesantemente sul budget pur restando invisibile nella media.
Latenza: il tempo end-to-end conta più del singolo modello
Un agente può usare un modello molto veloce e risultare comunque lento a causa dei tool. Se ogni step richiede una chiamata esterna di due secondi e il task dura quindici step, il collo di bottiglia non è il modello.
Conviene misurare almeno latency end-to-end, latenza per step, latenza dei tool, tempo speso in retry e percentili p50, p95 e p99. Il p95 è spesso più informativo della media perché mostra l’esperienza degli utenti meno fortunati.
Efficienza del percorso
Due agenti possono arrivare allo stesso risultato: uno in 6 passi, l’altro in 34. Il secondo non è necessariamente peggiore — alcuni task richiedono esplorazione — ma il numero di passi è un segnale importante.
Possiamo misurare tool call per task, numero di pianificazioni, retry, fallback e passi inutili. Quest’ultima metrica è difficile da automatizzare, ma molto utile nelle analisi qualitative.
Error recovery: testare il sistema quando qualcosa va storto
Un eval set composto soltanto da casi ideali misura soprattutto la capacità del modello. Per misurare l’agente bisogna introdurre problemi intenzionali: un tool che va in timeout, un documento mancante, dati contraddittori, una API che restituisce un errore 429, un campo obbligatorio assente.
Le domande diventano: l’agente riconosce il problema? Lo classifica correttamente? Tenta un retry appropriato? Cambia strategia? Chiede aiuto quando deve? Evita di inventare un risultato?
Testare la traiettoria o soltanto il risultato?
Non sempre esiste una sola traiettoria corretta. Un agente può risolvere un problema con strumenti diversi. Imporre una sequenza esatta di passi rischia quindi di trasformare l’eval in un test troppo rigido.
È più utile definire invarianti: condizioni che devono essere rispettate qualunque sia il percorso. Per esempio: nessuna azione irreversibile senza conferma, ogni dato finale deve avere una fonte, nessun accesso a sistemi non autorizzati, costo massimo entro una soglia.
Eval offline
Le valutazioni offline usano dataset e scenari controllati. Permettono di confrontare versioni diverse dell’agente in modo riproducibile. Sono ideali per regression test: una modifica al prompt, al modello o al planner non dovrebbe peggiorare task precedentemente risolti.
Un buon eval set dovrebbe includere task facili, medi, difficili, casi limite e casi deliberatamente avversariali. È importante inoltre congelare almeno una parte del set, per evitare di ottimizzare inconsapevolmente il sistema sui test.
Eval online
La produzione introduce utenti reali, dati sporchi, carichi variabili e comportamenti inattesi. Qui diventano utili metriche come tasso di abbandono, escalation umane, retry, correzioni manuali, feedback degli utenti e costo effettivo per sessione.
Le eval online non sostituiscono quelle offline. Servono a verificare che ciò che funziona nel laboratorio continui a funzionare nell’ambiente reale.
LLM-as-a-judge: utile, ma non infallibile
Un modello può essere usato per valutare automaticamente la qualità di una risposta o confrontare due output. È una tecnica potente perché consente di scalare le eval qualitative. Ma introduce bias: il giudice può preferire risposte più verbose, stili particolari o modelli simili a se stesso.
Quando il rischio è elevato, è consigliabile combinare giudizi automatici, regole deterministiche e campionamento umano. Nessun singolo livello dovrebbe essere considerato verità assoluta.
Dove le cose si complicano
Il problema più insidioso è che le metriche possono entrare in conflitto. Aumentare il numero di controlli può migliorare l’affidabilità ma peggiorare costo e latenza. Usare un modello più grande può aumentare il task completion rate ma ridurre la sostenibilità economica. Ridurre i passaggi può velocizzare il sistema ma eliminare verifiche utili.
La valutazione di un agente è quindi un problema multi-obiettivo. Non esiste “il punteggio” dell’agente: esiste una frontiera di compromessi coerente con il caso d’uso.
Una scorecard pratica
- Task completion rate
- Correctness del risultato
- Failure severity
- Cost per successful task
- Latency p50/p95
- Numero medio di tool call
- Retry e fallback rate
- Human escalation rate
- Varianza tra run
- Policy violation rate
Un agente non si valuta soltanto dalla risposta finale. Si valuta dal percorso, dal costo, dalla stabilità e soprattutto da ciò che fa quando il mondo non si comporta come previsto.
← Torna al percorso Dentro l’IA
Lascia un commento