
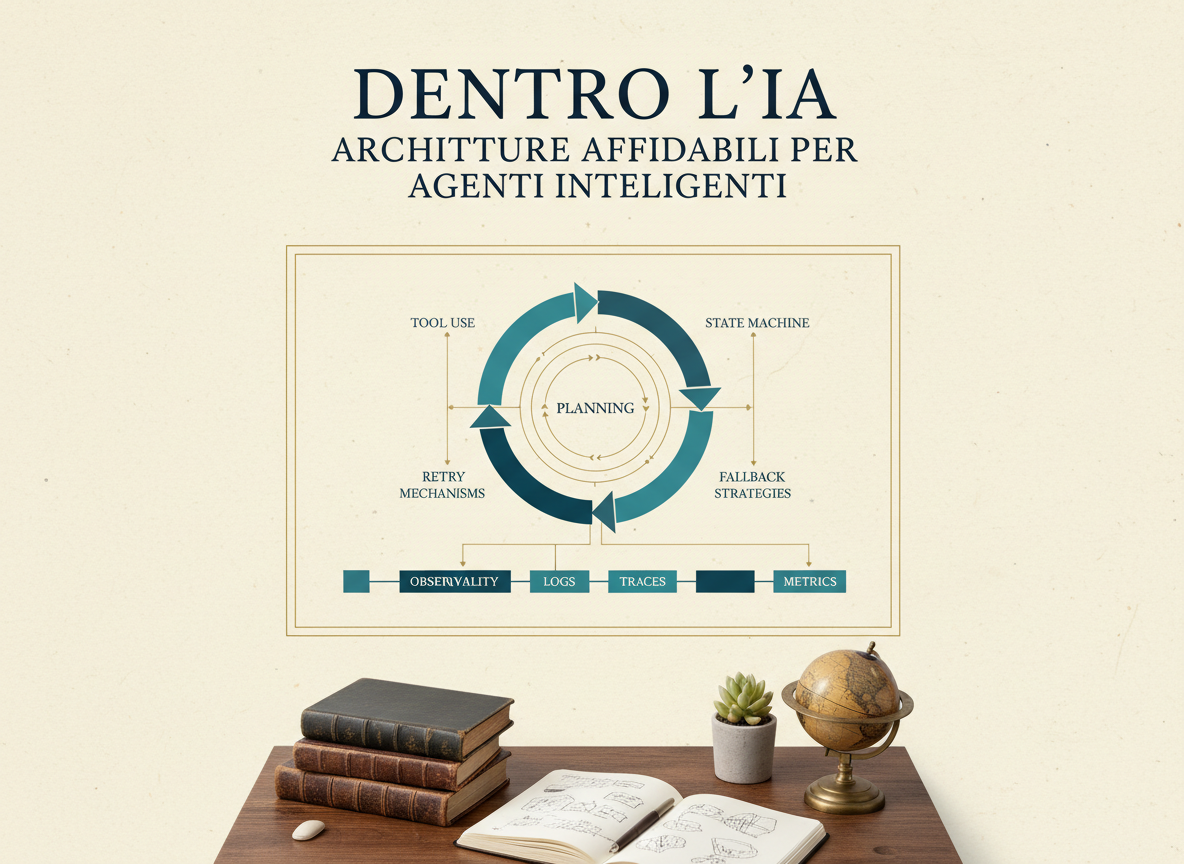
Un agente non è semplicemente un modello che risponde bene. È un sistema che deve perseguire un obiettivo nel tempo, scegliere quali passi compiere, usare strumenti, leggere risultati intermedi, correggersi e capire quando fermarsi. La difficoltà vera non è quindi farlo “agire”, ma costruire un meccanismo che gli impedisca di perdersi dopo tre, cinque o venti passaggi.
È qui che la progettazione di un agente diventa più simile all’ingegneria del software che al prompt engineering. Planning, stato, retry, fallback, osservabilità e gestione degli errori non sono dettagli accessori: sono ciò che separa una demo impressionante da un sistema affidabile.
In breve
- un agente deve trasformare un obiettivo in passi verificabili;
- ogni tool call può fallire o restituire dati incompleti;
- lo stato va mantenuto esplicitamente, non lasciato soltanto alla conversazione;
- retry e fallback devono modificare la strategia, non ripetere ciecamente;
- servono limiti di passi, costi e tempo;
- senza tracing e metriche non è possibile capire perché un agente ha fallito.

Dal goal al piano: il primo problema
Supponiamo che l’utente chieda: “Analizza le offerte ricevute per questa gara, confronta i requisiti tecnici e prepara una tabella con le anomalie”. Un chatbot può produrre una risposta; un agente deve invece costruire una sequenza di attività: individuare i documenti, estrarre i requisiti, leggere le offerte, normalizzare i dati, confrontare le evidenze, segnalare gli scostamenti e generare il risultato finale.
Possiamo rappresentare il ciclo in forma essenziale come G → P → A → O → V: goal, piano, azione, osservazione, verifica. Dopo la verifica il sistema può decidere di proseguire, ripianificare o terminare.
Il punto importante è che il piano non deve essere necessariamente completo all’inizio. Nei task aperti è spesso più robusto adottare un planning incrementale: decidere i prossimi passi sulla base di ciò che è stato effettivamente osservato. Pianificare cinquanta azioni in anticipo significa spesso costruire una sequenza fragile, perché basta un risultato inatteso al terzo passo per rendere obsoleto tutto il resto.
Planning statico e planning dinamico
Nel planning statico il sistema produce prima una lista di passi e poi li esegue. È semplice da comprendere e da controllare, ma funziona soprattutto quando l’ambiente è prevedibile. Nel planning dinamico, invece, il piano viene rivisto dopo ogni osservazione significativa.
Un approccio pratico consiste nel mantenere tre oggetti distinti: obiettivo, prossima azione e criterio di successo. Se il criterio non è soddisfatto, l’agente non dovrebbe limitarsi a “pensare ancora”, ma classificare il motivo del fallimento e scegliere una strategia alternativa.
Tool use: quando il linguaggio incontra il mondo esterno
Ricerca web, database, API, calcolo, file, browser e applicazioni aziendali trasformano il modello in un sistema operativo. Ma ogni strumento introduce nuovi failure mode: timeout, autenticazione scaduta, formato inatteso, dati mancanti, risposta vuota, rate limit, autorizzazioni insufficienti.
Per questo una tool call dovrebbe sempre avere almeno quattro elementi: precondizioni, input validati, criterio di successo e gestione dell’errore. Un agente che chiama un’API senza sapere come riconoscere una risposta valida non sta realmente controllando il processo.
Lo stato: ciò che l’agente deve sapere su se stesso
Una conversazione contiene testo, ma un agente ha bisogno di stato operativo. Deve sapere quali attività sono state completate, quali dati sono affidabili, quali tentativi sono già falliti, quali vincoli restano da soddisfare e quanto budget è stato consumato.
Lo stato può essere modellato esplicitamente, per esempio come struttura con campi: task corrente, risultati acquisiti, errori, tentativi, tool disponibili, costo accumulato e stato finale. Questo evita che informazioni decisive restino sepolte in decine di messaggi di contesto.
Pensarlo come una macchina a stati
Una delle astrazioni più utili è la state machine. Stati tipici possono essere Plan, Execute, Observe, Validate, Retry, Fallback, Escalate e Done.
Le transizioni dovrebbero dipendere da eventi osservabili: “tool riuscito”, “dato mancante”, “errore temporaneo”, “errore permanente”, “risultato non verificabile”, “budget esaurito”. Il vantaggio è enorme: invece di affidare tutto al comportamento emergente del modello, parte della logica diventa deterministica, testabile e ispezionabile.
Retry: riprovare, ma in modo intelligente
Un retry non dovrebbe essere una replica identica dell’azione fallita. Se una chiamata va in timeout, può avere senso un backoff progressivo. Se una query restituisce zero risultati, bisogna riformularla. Se un tool è indisponibile, occorre cambiarlo. Se un documento non contiene il dato cercato, serve un’altra fonte.
Una strategia robusta può seguire questa scala: retry tecnico → retry semantico → tool alternativo → ripianificazione → escalation. E deve sempre esistere un numero massimo di tentativi. Un agente che non sa fermarsi può trasformare un piccolo errore in una spirale di costi e chiamate inutili.
Fallback ed escalation
Il fallback è una via alternativa già prevista. Un modello più economico può essere sostituito da uno più capace; una ricerca vettoriale può essere affiancata da una ricerca lessicale; un’API può avere una fonte secondaria. Ma non tutto deve essere automatizzato.
Quando il sistema incontra un conflitto non risolvibile, un’azione irreversibile o dati ad alta criticità, la scelta corretta può essere escalare a una persona. L’autonomia non è il valore massimo in assoluto: in molti sistemi aziendali il valore è ottenere il miglior equilibrio tra autonomia, controllo e rischio.
Guardrail: l’agente deve sapere anche cosa non può fare
Un agente affidabile non dispone di libertà illimitata. È utile definire allowlist di strumenti, domini, operazioni e tipi di dati accessibili. Le azioni sensibili — cancellazioni, invii, acquisti, modifiche a sistemi produttivi — possono richiedere conferma esplicita.
Questi vincoli non servono soltanto per la sicurezza. Riducendo lo spazio delle azioni possibili si riduce anche la probabilità che il modello scelga una strada inutile o incoerente.
Osservabilità: vedere il processo, non soltanto l’output
Con un normale servizio software osserviamo richieste, errori e tempi. Con un agente dobbiamo osservare anche la traiettoria decisionale: quali strumenti ha usato, in quale ordine, con quali parametri, quali risultati ha scartato e perché ha deciso di proseguire.
Le metriche più utili includono: numero di passi, tool call per task, latenza per step, token consumati, costo cumulativo, retry, fallback, percentuale di task completati ed errori per categoria. Il tracing permette poi di ricostruire una singola esecuzione dall’inizio alla fine.
Dove le cose si complicano
Gli errori degli agenti non sono sempre locali. Una piccola interpretazione sbagliata al primo passo può propagarsi e produrre una conclusione molto convincente ma totalmente errata. Inoltre due esecuzioni dello stesso task possono seguire traiettorie diverse.
Per questo non basta verificare il risultato finale. Occorre inserire checkpoint, validazioni intermedie e invarianti: condizioni che devono restare vere durante tutto il processo. In un task amministrativo, per esempio, si può imporre che ogni dato riportato debba conservare il riferimento alla fonte da cui è stato estratto.
Un’architettura minima ragionevole
- Orchestratore: decide il prossimo stato.
- Planner: propone i passi necessari.
- Tool layer: espone soltanto azioni autorizzate e tipizzate.
- State store: conserva stato operativo e risultati.
- Validator: controlla output e criteri di successo.
- Policy layer: applica limiti, autorizzazioni e conferme.
- Telemetry: registra trace, metriche, costi ed errori.
Non tutti i progetti richiedono componenti separati, ma queste responsabilità dovrebbero comunque essere riconoscibili. Più l’agente è autonomo e più aumenta il valore di una struttura esplicita.
Un agente affidabile non è quello che non sbaglia mai. È quello che riconosce l’errore, tenta un recupero sensato e sa fermarsi prima di trasformare un errore in un danno.
Per approfondire
- Stuart Russell, Peter Norvig — Artificial Intelligence: A Modern Approach.
- Chip Huyen — AI Engineering.
- Letteratura recente su agentic workflows, tool use, orchestration e state management.
← Torna al percorso Dentro l’IA
Lascia un commento