
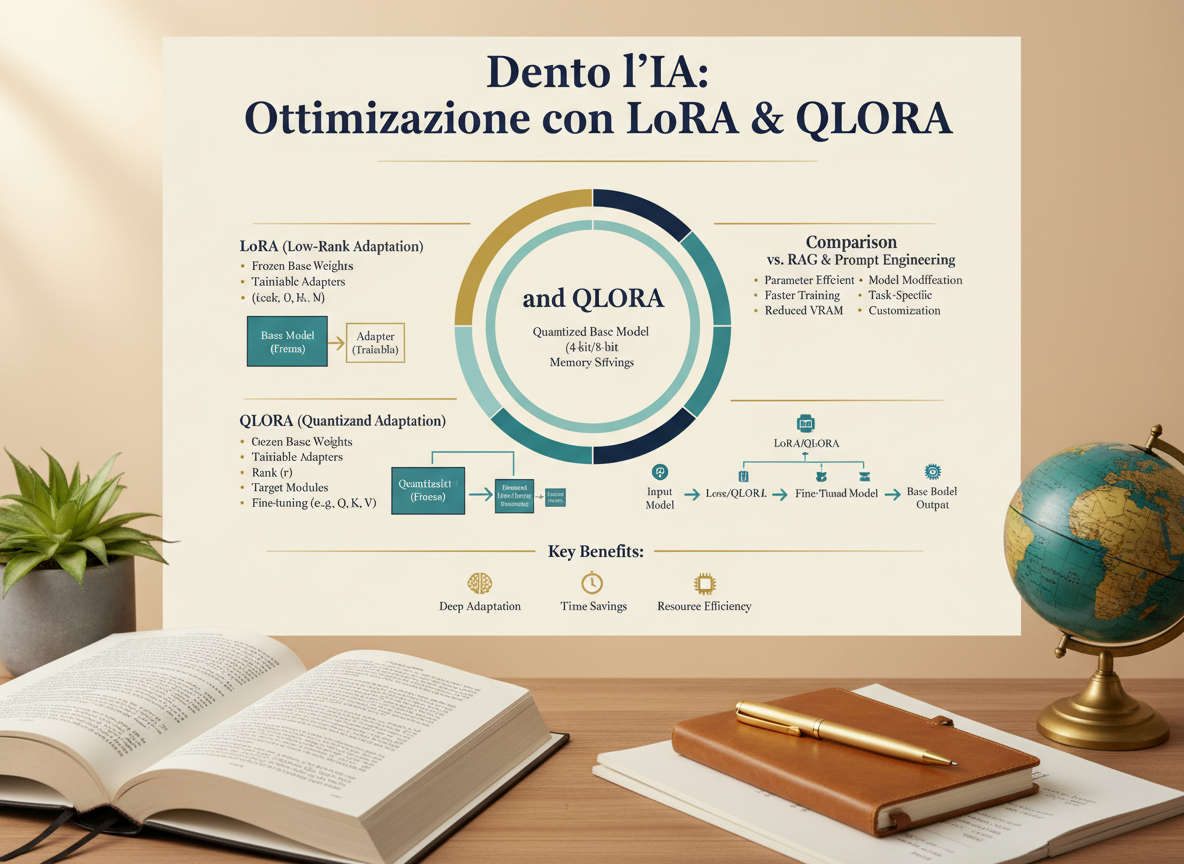
Fine-tuning non significa necessariamente riaddestrare tutti i pesi di un modello. Tecniche come LoRA e QLoRA nascono proprio dall’idea che, per adattare un LLM a un dominio o a un comportamento specifico, spesso non serve modificare miliardi di parametri: basta imparare una correzione molto più piccola.
È una differenza concettuale importante. Il modello di base conserva la propria conoscenza generale; l’adattamento aggiunge una componente specializzata. Questo rende il fine-tuning molto più economico, replicabile e praticabile anche su hardware non enorme.
In breve
- LoRA congela il modello di base e addestra matrici aggiuntive a basso rango;
- il numero di parametri addestrabili può ridursi di ordini di grandezza;
- QLoRA combina una base quantizzata, spesso a 4 bit, con adattatori LoRA addestrati a precisione maggiore;
- LoRA modifica soprattutto il comportamento, mentre il RAG aggiunge conoscenza esterna;
- adapter diversi possono essere mantenuti per compiti diversi sullo stesso modello base.

Il problema del fine-tuning completo
Nel fine-tuning classico si aggiornano molti o tutti i pesi del modello. Per un LLM di grandi dimensioni questo comporta costi elevati: memoria per i pesi, gradienti, stati dell’optimizer e attivazioni. La memoria necessaria durante l’addestramento può essere molte volte superiore alla sola memoria richiesta per l’inferenza.
Inoltre ogni variante specializzata richiederebbe, in linea di principio, una nuova copia completa del modello. Se un’organizzazione volesse una versione per il dominio legale, una per il supporto tecnico e una per il customer care, la gestione diventerebbe onerosa.
L’idea di LoRA
Supponiamo che una matrice di pesi del modello sia W. Nel fine-tuning completo aggiorniamo direttamente W. LoRA lascia invece W congelata e apprende una correzione ΔW espressa come prodotto di due matrici più piccole:
W’ = W + ΔW
ΔW = B · A
Se W ha dimensione molto grande, ma A e B hanno rango r piccolo, il numero di parametri da addestrare si riduce drasticamente.
Perché un aggiornamento a basso rango può bastare
L’ipotesi di fondo è che l’adattamento necessario per molti task occupi uno spazio di dimensione molto più bassa rispetto all’intero spazio dei parametri. In altre parole, per cambiare il comportamento del modello non serve muoversi liberamente in tutte le direzioni possibili.
LoRA cerca proprio queste direzioni “efficienti”. Il rango r controlla la capacità dell’adapter: un rango più alto offre maggiore flessibilità, ma aumenta memoria e parametri addestrabili.
Dove si inseriscono gli adapter
Gli adapter LoRA vengono normalmente applicati a specifiche proiezioni lineari del transformer, spesso nelle matrici dell’attenzione e talvolta nelle componenti feed-forward. Non esiste una configurazione universale: dipende dal modello, dal task e dal budget.
Parametri come r, alpha, dropout e target modules incidono sul comportamento. Copiare una configurazione trovata online può funzionare, ma una vera ottimizzazione richiede eval sul proprio dataset.
QLoRA: quantizzare la base, non l’apprendimento
QLoRA spinge ancora oltre il risparmio di memoria. Il modello di base viene caricato in forma quantizzata, spesso a 4 bit, mentre gli adattatori LoRA vengono addestrati con precisione maggiore.
L’idea è elegante: non abbiamo bisogno di aggiornare i pesi quantizzati della base; servono principalmente per il forward pass. I parametri realmente addestrabili restano quelli piccoli degli adapter.
NF4, double quantization e paged optimizers
QLoRA è associata a diverse tecniche che riducono ulteriormente il consumo di memoria. Una delle più note è NF4, un formato a 4 bit pensato per distribuzioni di pesi tipiche delle reti neurali. La double quantization quantizza anche alcuni parametri usati per la quantizzazione stessa, riducendo l’overhead.
I paged optimizers aiutano invece a gestire picchi di memoria durante l’addestramento. Il risultato pratico è che modelli che richiederebbero hardware molto più grande possono essere adattati con risorse relativamente contenute.
LoRA non è un database di conoscenza
Uno degli equivoci più comuni è usare il fine-tuning per “insegnare documenti” al modello. È possibile, ma spesso non è la scelta migliore. Se il problema è fornire informazioni aggiornabili — procedure, manuali, normativa, cataloghi — il RAG è generalmente più adatto.
LoRA è particolarmente efficace quando vogliamo modificare pattern stabili: stile, formato, terminologia, classificazione, comportamento o strategia di risposta.
Prompting, RAG o LoRA?
- Prompting: quando bastano istruzioni esplicite e pochi esempi.
- RAG: quando servono informazioni esterne, aggiornabili e citabili.
- LoRA/QLoRA: quando vogliamo modificare in modo stabile il comportamento del modello.
Nella pratica le tecniche possono essere combinate. Un modello adattato con LoRA può usare un sistema RAG e ricevere comunque un prompt specifico.
Un esempio concreto
Immaginiamo un assistente per una software house che deve trasformare ticket tecnici in schede strutturate. Se il problema è conoscere l’ultima versione della documentazione applicativa, conviene usare RAG. Se invece il modello deve imparare a produrre sempre una specifica struttura — sintesi, impatto, priorità, componente, proposta di risoluzione — un adattamento LoRA può rendere quel comportamento più stabile.
Adapter multipli sullo stesso modello
Uno dei vantaggi operativi è la possibilità di mantenere diversi adapter per compiti differenti senza duplicare l’intero modello base. Possiamo avere un adapter per il dominio legale, uno per classificazione, uno per stile editoriale e attivarli secondo necessità.
Questo apre anche scenari di adapter routing: il sistema sceglie quale specializzazione applicare in base al task.
Che cosa può andare storto
Il fatto che il fine-tuning sia economico non significa che sia automaticamente buono. Un dataset piccolo, rumoroso o sbilanciato può peggiorare il modello. Un adapter può imparare scorciatoie, stile eccessivamente rigido o bias presenti nei dati.
Inoltre una riduzione della training loss non garantisce migliore comportamento reale. Servono eval separate dal training set, casi limite e test di regressione rispetto al modello base.
Dove le cose si complicano
La scelta del rango, dei target modules e del dataset dipende fortemente dal task. Un adapter troppo piccolo può non avere capacità sufficiente; uno troppo grande può aumentare costi e rischio di overfitting.
Anche QLoRA non elimina tutti i costi: le attivazioni, il contesto e il batch continuano a richiedere memoria. Il guadagno principale riguarda la base quantizzata e il numero limitato di parametri addestrabili.
Una procedura pratica
- Definire con precisione il comportamento da modificare.
- Costruire un dataset piccolo ma di alta qualità.
- Stabilire una baseline con prompting e/o RAG.
- Addestrare un primo adapter LoRA con configurazione conservativa.
- Valutare su test separati e casi reali.
- Confrontare qualità, latenza e costi con la baseline.
LoRA non rende piccolo il modello: rende piccolo l’aggiornamento necessario per specializzarlo. QLoRA riduce anche la memoria della base, rendendo quell’adattamento accessibile su hardware molto più contenuto.
← Torna al percorso Dentro l’IA
Lascia un commento