
CAPIRE L’IA · 9 di N
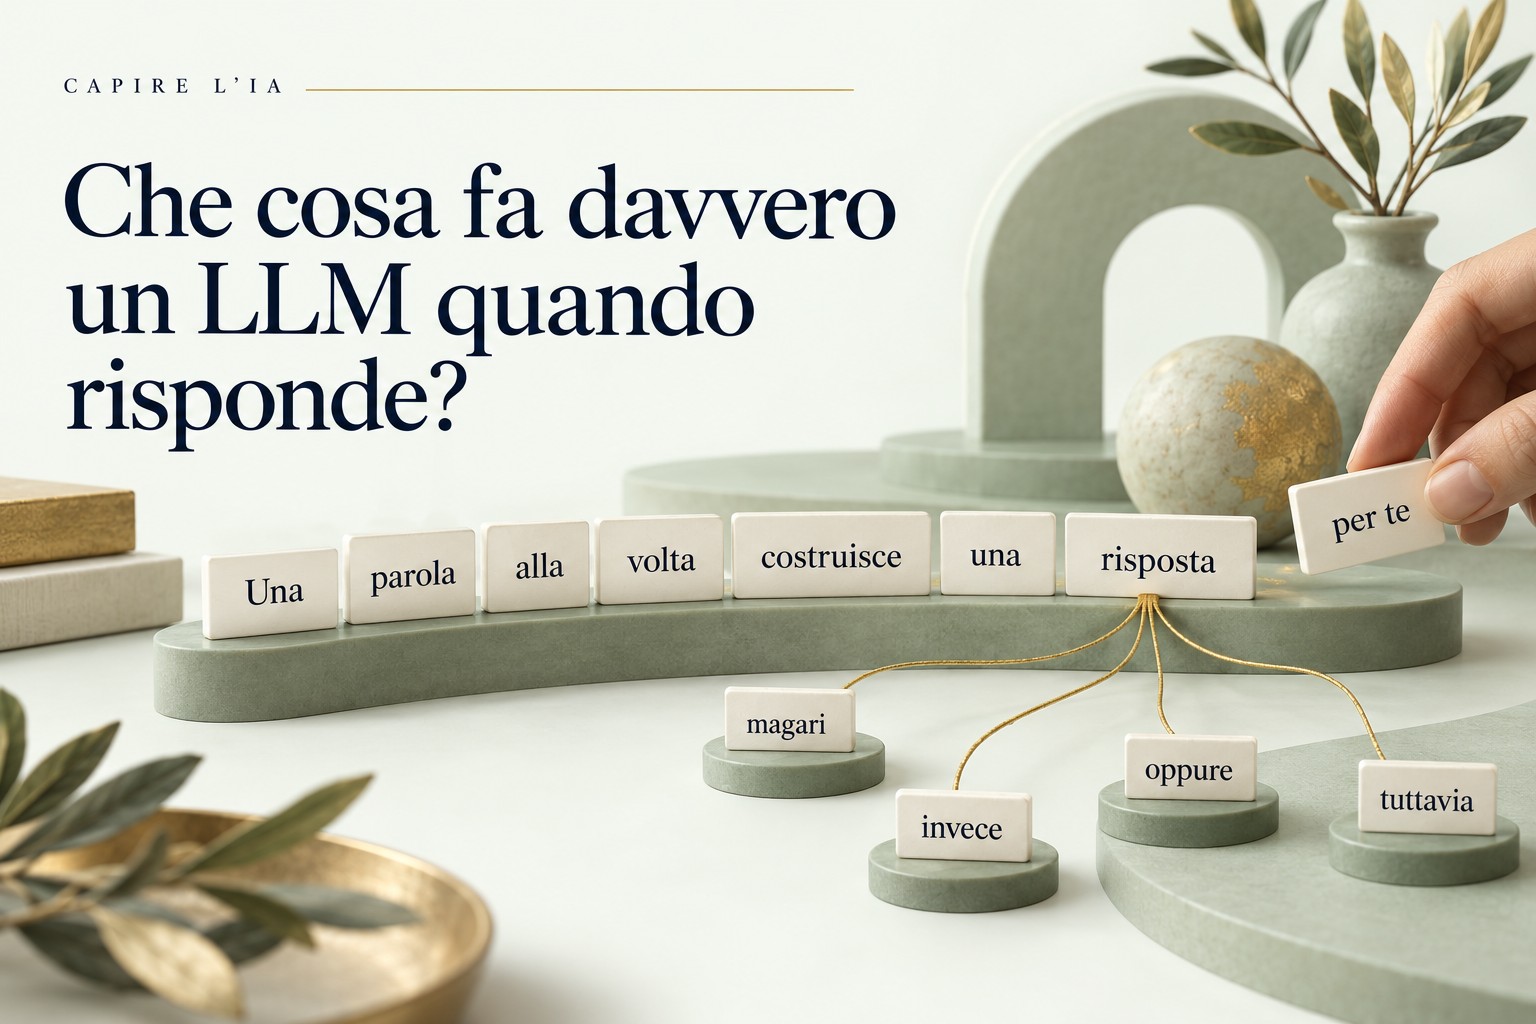
Scriviamo una domanda e compare una risposta: una definizione, un programma, una spiegazione matematica. L’interfaccia ci mostra un testo che cresce. Che cosa sta accadendo, esattamente, tra una parola e la successiva?
Nelle tappe precedenti abbiamo incontrato token ed embedding e il meccanismo dell’attenzione. Ora possiamo unirli: un modello linguistico autoregressivo costruisce una continuazione calcolando, ripetutamente, una distribuzione sul prossimo token.
La frase è semplice, ma va aperta con cura. «Prevedere il prossimo token» descrive un obiettivo e un modo di generare; non significa che il calcolo interno sia una banale ricerca della parola più frequente.
Prima della prima parola
Il modello riceve un contesto: può includere istruzioni, messaggi precedenti, la domanda e materiali aggiuntivi. La conversazione viene rappresentata in un formato che distingue i ruoli e poi trasformata in token. Le rappresentazioni attraversano i blocchi della rete.
Alla posizione finale, il risultato viene trasformato in un elenco di punteggi, uno per ogni token del vocabolario. Questi punteggi si chiamano logit. Non sono ancora probabilità e possono essere positivi o negativi.
Una forma semplificata del passaggio finale è z = hW + b: h è il vettore elaborato dalla rete, W una matrice appresa e b un eventuale termine di bias. Ritroviamo moltiplicazioni e somme già viste negli articoli sulle reti neurali.
Un esempio con tre soli candidati
Riprendiamo «La chiave accanto ai libri era…». Per fare i conti, immaginiamo un vocabolario ridotto a tre continuazioni, ciascuna trattata come un token: «arrugginita», «piccola» e «nuova». Un tokenizer reale potrebbe suddividerle e un vero vocabolario comprenderebbe molte altre possibilità.
Supponiamo che i logit siano (2, 1, 0). Sono valori inventati per illustrare il meccanismo, non misure di un modello reale. Applicando la softmax otteniamo:
pi = ezᵢ / Σj ezⱼ
Il denominatore è e² + e¹ + e⁰ ≈ 11,107. Le probabilità risultano circa 0,665, 0,245 e 0,090. Sommano a 1 perché abbiamo normalizzato sui tre candidati del nostro esempio.

Questa softmax somiglia a quella dell’attenzione, ma svolge un ruolo diverso. Nell’attenzione normalizzava collegamenti tra posizioni; qui normalizza punteggi sui possibili token in uscita.
Una distribuzione non è ancora una scelta
Con la selezione greedy si sceglie il candidato con probabilità massima: nel nostro esempio «arrugginita». Con il campionamento si estrae un candidato secondo la distribuzione: anche «piccola» o «nuova» possono essere selezionati.
La temperatura T modifica la distribuzione applicando la softmax ai logit divisi per T. Per T positivo e inferiore a 1 la distribuzione diventa più concentrata; per T maggiore di 1 diventa più uniforme. Il caso T = 0 viene spesso usato dalle interfacce per indicare una scelta deterministica, ma non si inserisce zero al denominatore della formula.
Nell’esempio, con T = 0,5 otteniamo circa (0,867; 0,117; 0,016); con T = 2 circa (0,506; 0,307; 0,186). Cambia la variabilità della scelta. Non abbiamo aggiunto nuove prove sulla chiave né reso automaticamente più vera una frase.
Altre strategie limitano i candidati: top-k conserva i k più probabili; top-p conserva un insieme dei più probabili sufficiente a raggiungere una massa cumulativa prefissata. Sono scelte di decodifica, distinte dai parametri appresi. La documentazione di Hugging Face presenta le principali strategie.
Il token scelto cambia il passo successivo
Dopo aver selezionato «arrugginita», la sequenza disponibile diventa «La chiave accanto ai libri era arrugginita». Il modello calcola una nuova distribuzione condizionata anche da questa aggiunta. Potrebbe seguire un punto, una virgola o un altro frammento di frase.
Non esiste una lista immutabile di parole future già pronta da svelare. Ogni scelta modifica il contesto delle successive. Implementazioni efficienti possono riutilizzare calcoli precedenti, per esempio attraverso una cache di key e value; il significato probabilistico del processo resta lo stesso.

Per una sequenza di token y₁, …, yₘ, la probabilità condizionata al contesto c si scompone così:
P(y₁, …, yₘ | c) = Πt=1…m P(yt | c, y₁, …, yt−1)
È la regola della catena delle probabilità. Non assume che i token siano indipendenti: ciascun fattore dipende dai precedenti. Se tre scelte hanno probabilità condizionate 0,6, 0,5 e 0,8, quella specifica sequenza ha probabilità 0,24 nel modello semplificato.
Scegliere sempre il token localmente più probabile non garantisce di trovare la sequenza globalmente più probabile. E nemmeno la sequenza più probabile è necessariamente la risposta più utile o corretta.
Perché risponde a una domanda invece di limitarsi a continuarla?
L’addestramento iniziale può fornire capacità linguistiche generali, ma un assistente deve anche imparare a seguire istruzioni, rispettare formati e gestire richieste. Fasi successive usano esempi di comportamento desiderato e, in alcuni casi, preferenze o ricompense.
Un riferimento storico è il lavoro su InstructGPT e il feedback umano: mostra un percorso che combina esempi supervisionati e ottimizzazione sulla base di preferenze. Non è la ricetta obbligatoria di ogni assistente. Serve a distinguere la capacità di continuare testo dal comportamento di un sistema conversazionale.
Durante la conversazione ordinaria, i parametri rimangono normalmente fissi. La risposta cambia perché cambia il contesto e può cambiare la procedura di selezione. Un’eventuale memoria del prodotto, conservata fuori dal modello, è un ulteriore meccanismo.
Predire token può sostenere calcoli complessi?
Per completare correttamente un programma può essere utile rappresentare variabili, vincoli e dipendenze. Per spiegare un problema può essere utile costruire risultati intermedi. Un obiettivo espresso sui token può quindi favorire l’apprendimento di strutture interne più ricche di una semplice frequenza locale.
Il fatto che l’uscita sia generata in sequenza non decide da solo se una particolare prestazione meriti il nome di ragionamento. Occorre guardare il comportamento: correttezza, robustezza a variazioni, generalizzazione e possibilità di verificare i passaggi. Una spiegazione fluida non dimostra di per sé che quei passaggi descrivano fedelmente tutti i calcoli interni.
Quando finisce la risposta?
La generazione può terminare con un token speciale di fine, una sequenza di arresto o il raggiungimento di un limite. La quantità di testo visualizzata dipende anche dall’applicazione. Se il sistema usa strumenti, una parte dell’uscita può diventare una richiesta strutturata anziché una frase destinata all’utente.
La distinzione centrale resta questa: il modello assegna probabilità a continuazioni, mentre il sistema organizza contesto, selezione, strumenti e presentazione. Per comprendere un assistente bisogna osservare entrambi.
Tre cose da conservare
- La rete produce punteggi, poi una distribuzione. La procedura di decodifica sceglie il token successivo.
- Ogni scelta entra nel contesto delle successive. La risposta si costruisce attraverso dipendenze condizionate.
- Probabilità linguistica e correttezza sono cose diverse. Una continuazione favorita dal modello può contenere un errore.
Quest’ultimo punto apre la prossima tappa: perché un testo costruito così può essere convincente anche quando racconta qualcosa di falso?
← Torna al percorso Capire l’IA
Lascia un commento