Categoria: IA, società e potere

  • Mistral Large 4, «Le Chonk»: che cosa cambia con i pesi aperti

    Mistral Large 4, «Le Chonk»: che cosa cambia con i pesi aperti

    Mistral Large 4, presentato da Mistral con il soprannome Le Chonk, è arrivato in anteprima pubblica il 6 ottobre 2026; il 29 ottobre l’azienda ha reso disponibili i pesi della versione aggiornata. La notizia conta per la scala del modello, ma soprattutto perché un sistema di frontiera può essere scaricato e adattato, invece di essere usato soltanto attraverso il servizio del produttore.

    La sintesi qui sotto riprende i punti centrali dell’articolo di Rivista.AI e li confronta con il comunicato e la documentazione tecnica di Mistral. I benchmark sono risultati dichiarati dai rispettivi autori, non una valutazione indipendente svolta per questo articolo.

    Un modello enorme, ma attivo in modo selettivo

    Mistral Large 4 è un modello multimodale basato su un’architettura Mixture of Experts. La scheda tecnica di Mistral indica 1,05 mila miliardi di parametri complessivi e 52 miliardi attivi, oltre a un encoder visivo da 1,6 miliardi. La documentazione d’implementazione distingue circa 49 miliardi attivi nel nucleo del modello: i 52 miliardi conteggiano anche embedding e strati di output. Nei 71 blocchi Mixture of Experts, il router seleziona quattro dei 128 esperti e affianca un esperto condiviso. La dimensione totale descrive quindi la capacità disponibile, non il calcolo eseguito integralmente a ogni passaggio.

    Il modello accetta testo e immagini, dichiara una finestra di contesto di un milione di token e supporta oltre 160 lingue. Sono caratteristiche adatte, per esempio, ad analizzare documenti lunghi, repository software o materiale visivo. Ma una finestra ampia non garantisce da sola che ogni dettaglio venga recuperato correttamente: la qualità va provata sui documenti, sulle lingue e sui compiti reali di ciascuna organizzazione.

    Che cosa vuol dire “pesi aperti”

    Con i pesi scaricabili, un’organizzazione può valutare il modello, adattarlo e distribuirlo sulla propria infrastruttura, senza dipendere per ogni richiesta dall’API di Mistral. Questo può aiutare quando contano la residenza dei dati, la personalizzazione o il controllo sul servizio. Non equivale però a ottenere un sistema leggero o gratuito da gestire: servono hardware adeguato, energia, competenze operative, manutenzione e misure di sicurezza.

    Anche la licenza richiede attenzione. Mistral Large 4 è distribuito con la Mistral Ecosystem Open-Weight License, una licenza derivata dalla MIT che consente uso, modifica e commercializzazione, ma prevede una licenza commerciale separata per chi offre il modello come servizio Model-as-a-Service. “Open-weight” descrive l’accesso ai parametri; non significa assenza di condizioni né coincide automaticamente con ogni definizione di software open source.

    Cybersecurity: distinguere i numeri

    La sicurezza informatica è una delle aree su cui Mistral concentra il posizionamento del modello. Nel rilascio del 29 ottobre, l’azienda riporta 51% sull’Artificial Analysis Cyber Index, che valuta un percorso più ampio: individuare una vulnerabilità, riprodurla e correggerla senza compromettere il software. Il dato dell’82% citato da Hugging Face riguarda invece uno specifico test di riproduzione e correzione di vulnerabilità open source. Sono misure diverse e non vanno messe sullo stesso piano come se fossero lo stesso benchmark.

    Mistral dichiara inoltre un tasso medio di rifiuto del 96,6% su richieste informatiche malevole nei test indicati nel comunicato. Nessuna percentuale, da sola, certifica che un sistema sia sicuro: i risultati dipendono da test, condizioni e definizioni adottate. La pubblicazione dei pesi rende il controllo più accessibile ai ricercatori e ai difensori, ma consente anche modifiche e distribuzioni fuori dal controllo diretto del produttore. Mistral riconosce il rischio di uso offensivo e dichiara di aggiornare le proprie protezioni.

    La scelta economica non si riduce al prezzo per token

    Per l’uso via API, Mistral indica prezzi di 0,70 dollari per milione di token in ingresso, 0,07 per gli ingressi serviti dalla cache e 2,10 per milione di token generati. Sono un riferimento da confrontare con il costo dell’esecuzione autonoma, non una prova che una delle due opzioni sia sempre più conveniente. Un calcolo completo deve includere utilizzo delle GPU, personale, consumo energetico, manutenzione e volume effettivo di richieste.

    La distribuzione comprende formati FP8 e NVFP4; la comunità ha inoltre prodotto quantizzazioni GGUF. Il fatto che i file siano scaricabili non implica quindi che il modello sia pratico su una workstation comune. Un’installazione privata può avere senso per carichi elevati o requisiti rigorosi sui dati; per un uso sporadico, un’API gestita può restare la scelta più semplice.

    Che cosa cambia per l’Europa

    Le Chonk rende più concreta la possibilità di scegliere un modello di frontiera sviluppato e addestrato in Europa, con pesi disponibili e opzioni di distribuzione autonome. Per imprese e pubbliche amministrazioni può ampliare le alternative quando la gestione di informazioni sensibili o la dipendenza da un fornitore sono questioni decisive.

    Non basta però che il modello sia europeo perché lo sia l’intera infrastruttura: l’autonomia dipende anche da chip, cloud, filiera, competenze e governance. Il rilascio sposta parte del controllo verso chi adotta il sistema; non elimina automaticamente le dipendenze tecnologiche né i costi. Il suo impatto si misurerà nella qualità delle applicazioni costruite, nell’affidabilità operativa e nella sostenibilità economica, oltre che nei benchmark.

    Il punto non è soltanto avere accesso ai pesi: è poter gestire in modo sostenibile e responsabile il sistema che li usa.

    Fonti e approfondimenti

  • IA aperta e sovranità tecnologica: la libertà di poter cambiare

    IA aperta e sovranità tecnologica: la libertà di poter cambiare

    Se domani dovessimo cambiare il fornitore della nostra intelligenza artificiale, che cosa riusciremmo a portare con noi? I documenti, certo. Ma anche le personalizzazioni, i criteri con cui valutiamo le risposte, la memoria degli agenti, le integrazioni con i sistemi e le competenze necessarie per far funzionare tutto? E con quali costi e tempi?

    È una delle domande che pone Open Source, il potere di scegliere, settimo paper della serie Sovranità Tecnologica di Rivista.AI, a cura di Franco Bernabè, realizzato in collaborazione con TechVisory e con i contributi di Andrea David Passarelli, Antonio Dina e Fabio Ricceri. Un lavoro che ricostruisce il percorso dal software libero ai modelli di IA e propone un criterio molto concreto per ragionare sull’autonomia: la reversibilità delle scelte tecnologiche.

    Questa chiave di lettura mi sembra particolarmente utile perché collega un dibattito spesso astratto alle decisioni quotidiane di imprese e amministrazioni: che cosa acquistiamo, quali capacità conserviamo e quanto ci costerebbe cambiare strada.

    Dal codice aperto ai modelli: che cosa è cambiato

    Nel software tradizionale, la disponibilità del codice sorgente e delle libertà previste dalla licenza permette di studiare un programma, modificarlo e affidarne l’evoluzione anche a soggetti diversi dal produttore originario. Il paper ripercorre questa storia, dal progetto GNU a Linux, fino alle comunità che hanno costruito una parte importante dell’infrastruttura digitale.

    Con l’intelligenza artificiale la struttura dell’oggetto cambia. Accanto al codice ci sono i pesi, cioè i parametri appresi durante l’addestramento, i dati utilizzati, le procedure di preparazione e ottimizzazione, gli strumenti per eseguire il modello. L’apertura può riguardare soltanto alcuni di questi elementi.

    Scaricare i pesi può consentire di eseguire e adattare un modello, nei limiti della sua licenza. Ricostruire il percorso che lo ha prodotto richiede molte altre informazioni e risorse. È qui che due espressioni spesso usate come equivalenti cominciano a indicare cose diverse.

    Open source, open weight e API: tre cose da distinguere

    ModalitàChe cosa rende disponibileChe cosa verificare
    Accesso via APIUn servizio che riceve richieste e restituisce risultati.Continuità, gestione dei dati, variazioni del servizio e portabilità delle integrazioni.
    Open weightI parametri appresi dal modello, con condizioni di utilizzo definite dalla licenza.Usi consentiti, modifiche, redistribuzione e risorse necessarie per eseguirlo.
    Open source AI secondo OSILibertà d’uso, studio, modifica e condivisione, con codice, parametri e informazioni sui dati richiesti dalla definizione.Completezza dei materiali e condizioni effettive di accesso e riutilizzo.
    Le categorie descrivono dimensioni diverse: anche un modello aperto può essere offerto tramite API. Elaborazione dal paper e dalla Open Source AI Definition 1.0.

    La Open Source AI Definition 1.0 dell’Open Source Initiative richiede codice, parametri e informazioni sui dati sufficientemente dettagliate da consentire a una persona competente di costruire un sistema sostanzialmente equivalente. Non impone che ogni dato di addestramento sia necessariamente redistribuibile: distingue l’accesso ai dati dalle informazioni necessarie a descriverli. È una scelta discussa, richiamata anche nel paper, che rende ancora più importante leggere i materiali disponibili e le licenze del singolo modello.

    La distinzione serve a capire quali libertà si stanno acquisendo. La parola “open”, da sola, lascia troppe domande senza risposta.

    L’apertura è anche una strategia industriale

    Uno dei passaggi più interessanti del paper riguarda la geopolitica. Nella sua lettura, la diffusione dei modelli aperti diventa uno strumento per costruire ecosistemi: attirare sviluppatori, favorire l’adozione di strumenti, rendere familiari certi formati e orientare gli standard.

    I casi statunitensi e cinesi, comprese le famiglie DeepSeek e Qwen discusse nel documento, mostrano perché il rilascio dei pesi possa avere un valore strategico anche per chi lo promuove. Un’organizzazione può rendere accessibile una componente e ricavare vantaggio dai servizi, dalle piattaforme o dalle infrastrutture che crescono intorno a essa.

    Per chi adotta queste tecnologie, il beneficio può essere reale: più possibilità di sperimentare, confrontare e personalizzare. La conseguenza da tenere presente è che il potere economico può spostarsi lungo la filiera. Valutare ciascun modello e ciascun servizio diventa più utile che assegnare un’etichetta definitiva a un’intera azienda o a un Paese.

    NVIDIA: il valore di ciò che fa funzionare il modello

    Il caso NVIDIA rende evidente questo ragionamento. La sua documentazione su Nemotron presenta una famiglia di modelli aperti e un insieme di strumenti per sviluppare e distribuire sistemi agentici. Il paper interpreta questa strategia anche alla luce del ruolo dell’azienda nelle infrastrutture di calcolo.

    L’interpretazione economica è plausibile: se cresce l’utilizzo dei modelli, può crescere la domanda delle risorse necessarie a eseguirli. Inoltre, le ottimizzazioni e gli strumenti adottati possono rendere costoso un successivo trasferimento verso un altro ambiente. Questa è una lettura della strategia industriale, da distinguere dalle caratteristiche tecniche dichiarate dal produttore.

    Dal punto di vista dell’utilizzatore, occorre quindi valutare anche il software di esecuzione, le prestazioni ottenibili su hardware diverso, le persone necessarie alla gestione e il costo del servizio nel tempo.

    Tre livelli sui quali costruire autonomia

    Per mettere ordine, il paper distingue tre capacità: costruire, servire e far agire. Nella grafica traduco “servire” con “eseguire”: significa mettere il modello nelle condizioni di rispondere alle richieste, con tempi, costi e qualità adeguati.

    Tre livelli dell’autonomia nell’IA: costruire, verificando pesi, codice, dati e licenze; eseguire, controllando calcolo, software e costi; far agire, governando strumenti, memoria, accessi e registri. La reversibilità preserva dati, competenze e continuità operativa.
    Tre livelli da governare insieme. Elaborazione originale Angolo 1729 dal paper Rivista.AI, Open Source, il potere di scegliere, ottobre 2026. Clic sull’immagine per ingrandire.

    Costruire riguarda il modello e il patrimonio di conoscenze necessario per comprenderlo, valutarlo e adattarlo. Per molte organizzazioni significherà scegliere e specializzare modelli esistenti: addestrarne uno da zero è una decisione molto diversa, per risorse e obiettivi.

    Eseguire riguarda l’inferenza, ossia l’impiego del modello per produrre risultati: capacità di calcolo, memoria, energia, software, monitoraggio e competenze operative. La disponibilità dei pesi amplia le alternative; la sostenibilità dipende da ciò che occorre per utilizzarli davvero.

    Far agire riguarda gli agenti e i processi. Quando un sistema consulta archivi, usa strumenti o interviene sulle applicazioni, diventano centrali autorizzazioni, memoria, registri delle operazioni e passaggi di controllo umano. Anche questi elementi devono poter essere compresi e trasferiti.

    Un esempio concreto: l’assistente documentale di un ente

    Immaginiamo un’amministrazione che introduca un assistente per aiutare gli uffici a orientarsi fra circolari, regolamenti e documentazione interna. Il modello ha pesi disponibili e gira in un ambiente scelto dall’ente. Dopo un anno, il fornitore cambia condizioni economiche e l’amministrazione decide di valutare un’alternativa.

    È il momento della prova. I documenti originali sono ancora accessibili, ma il sistema comprende anche gli indici di ricerca, le regole di accesso, le istruzioni, le configurazioni, i collegamenti alle applicazioni e i casi usati per verificare la qualità delle risposte. Alcuni elementi si possono esportare; altri potrebbero dover essere ricostruiti.

    Se una nuova soluzione richiede di rigenerare gli indici, rivalidare le risposte e riscrivere molte integrazioni, il cambio rimane possibile ma ha un costo. La reversibilità diventa credibile quando quel costo è conosciuto e sostenibile. È un esempio applicativo che propongo a partire dalla tesi del paper.

    Cinque domande da portare al tavolo di progetto

    Per tradurre questa riflessione in una scelta concreta, partirei da cinque domande da affrontare insieme al fornitore:

    • Che cosa riceviamo? Quali componenti sono accessibili, con quali licenze e con quale documentazione?
    • Che cosa possiamo trasferire? Dati, configurazioni, istruzioni, integrazioni e strumenti di valutazione devono avere una destinazione praticabile.
    • Quanto costa cambiare? Vanno stimati il trasferimento, le eventuali ricostruzioni, la formazione e il periodo di funzionamento parallelo.
    • Come verifichiamo la continuità? Una prova su un secondo ambiente dovrebbe misurare qualità delle risposte, tempi e rispetto degli accessi.
    • Chi conserva le competenze? L’organizzazione deve poter comprendere il sistema e guidarne l’evoluzione anche quando cambiano gli interlocutori.

    Sono criteri progettuali da adattare alla criticità del servizio. Una sperimentazione circoscritta richiede un impegno diverso da un sistema integrato nei processi essenziali di un’amministrazione. Il valore sta nel rendere la verifica proporzionata e concreta.

    Europa e Italia: collegare capacità diverse

    Il paper invita a considerare insieme ricerca, infrastrutture, imprese e domanda pubblica. Per l’Italia, il patrimonio da valorizzare comprende la conoscenza dei processi produttivi e amministrativi, i dati di qualità e le competenze di chi sa costruire servizi affidabili.

    Fra gli esempi citati, Minerva nasce dal lavoro di Sapienza NLP con FAIR e CINECA. Sul versante industriale, Engineering presenta IS-IA, costruita su EngGPT 2, come un approccio per governare il ciclo dell’IA, dall’infrastruttura all’orchestrazione nei processi. Sono iniziative con origini e finalità differenti: la loro presenza illustra la varietà delle capacità disponibili, senza stabilire un’equivalenza fra livelli di apertura o risultati operativi.

    Il punto che condivido con voi è la necessità di far comunicare queste capacità. Adottare componenti aperti può diventare un investimento duraturo quando lascia competenze, strumenti riutilizzabili e possibilità di intervenire sul sistema. Partecipare allo sviluppo dei progetti, contribuendo a codice e documentazione, aiuta inoltre a comprendere e influenzare le scelte da cui si dipenderà.

    La libertà si prepara mentre il sistema funziona

    La domanda iniziale resta la più utile: che cosa potremmo portare con noi se dovessimo cambiare? Rispondere mentre un servizio funziona bene permette di progettare con maggiore lucidità, verificare le alternative e capire quali dipendenze accettare.

    Nella mia lettura, il merito del paper è aver dato alla sovranità tecnologica una dimensione verificabile nei progetti. L’apertura acquista valore quando si traduce in capacità di scelta, manutenzione e sostituzione. È su queste capacità che un’impresa o un’amministrazione può costruire una relazione duratura con la tecnologia.

    La libertà di cambiare si costruisce prima del momento in cui diventa necessaria.

    Per continuare su Angolo 1729

    Fonti e approfondimenti

    Fonte principale: Rivista.AI, Open Source, il potere di scegliere. Come i modelli aperti stanno cambiando gli equilibri tecnologici tra Stati Uniti, Cina ed Europa, serie Sovranità Tecnologica, n. 07, ottobre 2026, a cura di Franco Bernabè, in collaborazione con TechVisory. Presentazione del paper e download sul sito dell’editore.

  • Se l’IA risolve tutto, chi inventerà le prossime domande?

    Se l’IA risolve tutto, chi inventerà le prossime domande?

    Se l’intelligenza artificiale diventasse bravissima a risolvere i problemi matematici, sapremmo ancora coltivare le domande? Una lettura dell’articolo di Maurizio Codogno su MaddMaths! e qualche riflessione sul futuro della ricerca.

    C’è una domanda che mi resta in testa dopo aver letto E quando finiscono i problemi?, l’articolo di Maurizio Codogno su MaddMaths!: che cosa succederebbe alla matematica se le macchine esaurissero il lavoro dei risolutori, dei matematici? È una provocazione che merita attenzione, soprattutto per chi ama insieme la matematica e l’intelligenza artificiale.

    La preoccupazione di Codogno

    Codogno parte dai risultati matematici attribuiti ai modelli di IA e invita a guardare oltre il loro numero. Richiama la necessità di controllare le dimostrazioni e il «problema del denominatore»: conoscere i successi serve a poco se ignoriamo quanti tentativi li hanno prodotti. Distingue inoltre la soluzione dei problemi dalla creazione di nuove idee.

    Il suo timore più profondo riguarda la comunità scientifica. Nell’ipotesi di sistemi capaci di risolvere i problemi aperti senza alimentare nuove direzioni di ricerca, potrebbe venir meno la massa critica di persone che mantiene viva la disciplina. È uno scenario ipotetico, non la dimostrazione di un destino inevitabile.

    Gli annunci specifici discussi nell’originale vanno letti insieme alle riserve sulla loro verifica espresse dallo stesso autore. Qui interessa soprattutto la questione culturale che sollevano: quale attività matematica vogliamo preservare e rendere possibile?

    Una dimostrazione è anche un’occasione per capire

    Da questa domanda vorrei partire per una riflessione ulteriore. Immaginiamo due risposte allo stesso problema. La prima certifica che un’affermazione è vera attraverso un ragionamento lunghissimo e difficile da seguire. La seconda rende visibile una relazione che prima ci sfuggiva e permette di riconoscerla in situazioni diverse. Entrambe possono essere corrette; per chi studia, però, offrono esperienze molto differenti.

    Disporre di una prova e riuscire a farla propria sono due traguardi distinti. Una prova può chiudere una questione, mentre la sua comprensione può aprire un percorso. La sfida educativa sarebbe quindi insegnare a interrogare anche risultati già disponibili: quali ipotesi sono indispensabili? Dove interviene l’idea decisiva? Che cosa smette di funzionare cambiando il problema?

    Un piccolo esempio: dopo la somma, le domande

    Prendiamo un risultato elementare: la somma dei primi n numeri dispari è n². Possiamo controllarlo con qualche calcolo: 1 + 3 + 5 + 7 = 16. Possiamo anche immaginare quadrati di punti che crescono aggiungendo ogni volta un bordo a forma di L.

    Il passaggio da un quadrato di lato n a uno di lato n + 1 aggiunge esattamente 2n + 1 punti, perché (n + 1)² − n² = 2n + 1. Partendo dal primo punto, questa osservazione dimostra la formula per ogni intero positivo n.

    Ora la risposta è nota, ma la curiosità può continuare. Che cosa succede passando dai quadrati ai cubi? Quale figura rappresenta la differenza fra due cubi consecutivi? E come si può trasformare un’immagine intuitiva in un ragionamento generale? Questo esempio elementare non predice il futuro della ricerca. Mostra però un’esperienza accessibile a tutti: una soluzione può diventare materiale per una nuova domanda.

    Il rischio di saltare l’apprendimento

    C’è poi una questione che sembra a me centrale: come si diventa capaci di porre domande interessanti? Difficilmente basta ricevere molte risposte. Occorre confrontarsi con tentativi che falliscono, esempi che ingannano, ipotesi troppo forti o troppo deboli.

    Se immaginiamo un ambiente in cui ogni difficoltà viene immediatamente delegata, dobbiamo chiederci dove avvenga questo apprendistato. Non perché la fatica sia un valore in sé (i matematici odiano la fatica mi insegnó il mio professore di Ricerca Operativa), ma perché alcuni tentativi costruiscono la capacità di giudicare il risultato successivo. La scelta didattica potrebbe essere affidare alla macchina una parte del lavoro e chiedere allo studente di ricostruire il passaggio essenziale, trovare un controesempio o modificare le ipotesi.

    Quale matematica vogliamo continuare a fare?

    La provocazione di Codogno mi interessa perché costringe a esplicitare che cosa amiamo della matematica. La soddisfazione di risolvere un problema conta. Contano anche la possibilità di discutere una prova con qualcuno, di trovare una spiegazione più limpida, di riconoscere una struttura inattesa.

    Non darei per scontato né che l’automazione distruggerà queste esperienze né che le renderà automaticamente più ricche. Molto dipenderà dagli spazi che sapremo costruire per studiare, condividere e comprendere i risultati. La domanda che porterei con me, dopo questa lettura, è dunque molto concreta: se le risposte diventano più facili da ottenere, come rendiamo più profonda la nostra capacità di fare domande?

    La lettura da cui partire

    Maurizio Codogno, E quando finiscono i problemi?, MaddMaths!, rubrica Diario di un matematico non praticante.

  • Cloud e IA: 9,48 miliardi in Italia, ma quanta autonomia?

    Cloud e IA: 9,48 miliardi in Italia, ma quanta autonomia?

    Il cloud italiano vale sempre di più. Quanto aumenta, insieme alla spesa, la nostra capacità di scegliere come usarlo? La domanda attraversa il rapporto fra intelligenza artificiale e sovranità digitale: acquistare capacità di calcolo permette di innovare, ma rende decisivi i contratti, le competenze e le alternative disponibili.

    Lo spunto arriva da Rivista.ai, che mette al centro la concentrazione del mercato, e dall’approfondimento di AI4Business, utile per collegare quei numeri alle scelte quotidiane delle imprese. Alla base c’è la medesima ricerca 2026 dell’Osservatorio Cloud Ecosystem & Sovereignty del Politecnico di Milano.

    9,48 miliardi: che cosa stiamo misurando

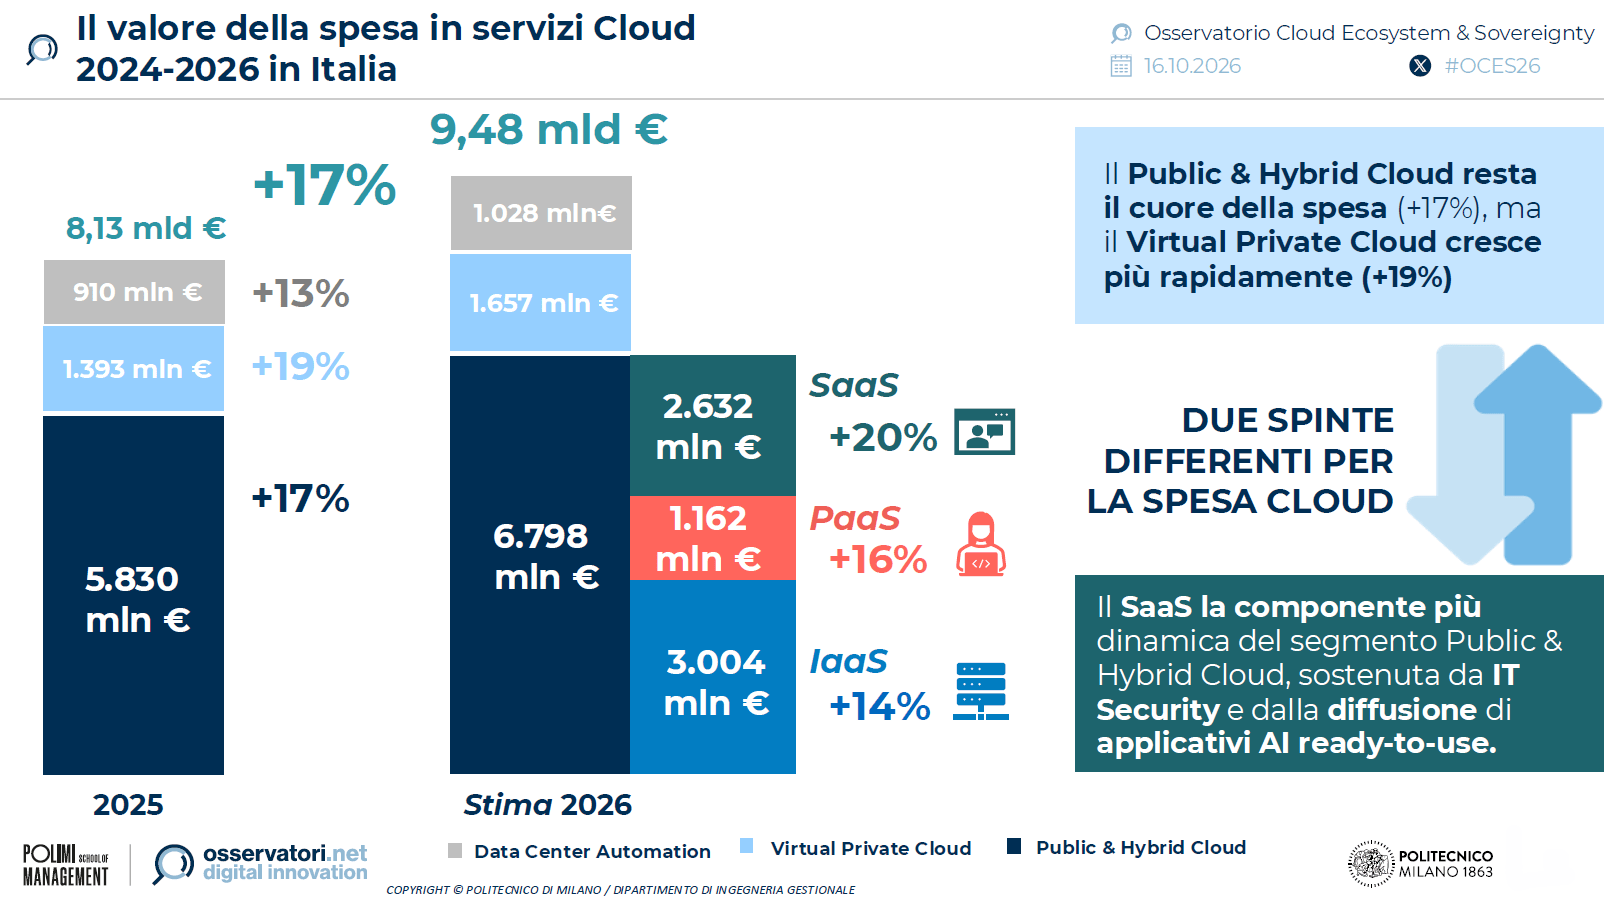
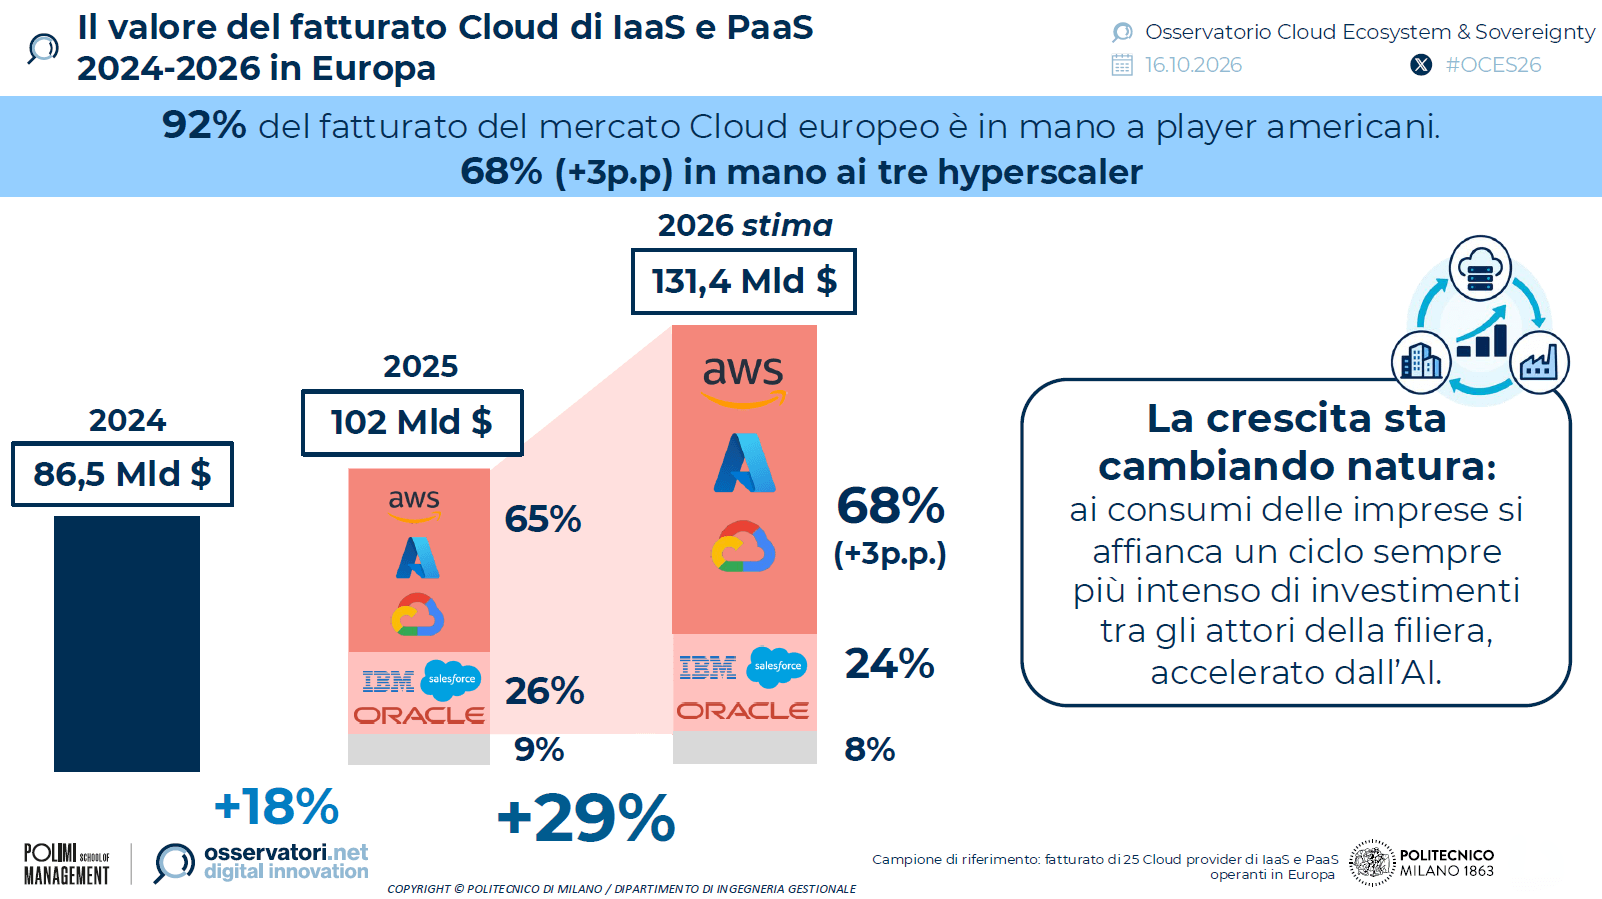
    La stima per il 2026 porta la spesa cloud delle organizzazioni italiane a 9,48 miliardi di euro, in crescita del 17%. Nel perimetro europeo IaaS e PaaS analizzato dall’Osservatorio, i ricavi dei provider sono stimati in 131,4 miliardi di dollari, +29%. Le due crescite descrivono fenomeni diversi: in Italia si misura la domanda delle organizzazioni utilizzatrici; in Europa i ricavi dei fornitori, che comprendono anche acquisti di capacità effettuati all’interno della filiera digitale.

    Nel campione europeo di 25 provider, AWS, Microsoft e Google raccolgono il 68% dei ricavi. Gli altri operatori statunitensi aggiungono il 24%: da qui il 92% complessivo. Il restante 8% comprende anche operatori europei. Sono quote economiche dei servizi infrastrutturali e di piattaforma analizzati: non misurano la quantità di dati europei conservati negli Stati Uniti.

    Stime 2026: spesa cloud italiana di 9,48 miliardi di euro, +17%; ricavi europei IaaS/PaaS di 131,4 miliardi di dollari, +29%. AWS, Microsoft e Google hanno il 68%, altri provider USA il 24%, altri operatori l’8%.
    Stime 2026 e concentrazione dei ricavi. Italia ed Europa hanno perimetri e valute diversi. Fonte: Osservatorio Cloud Ecosystem & Sovereignty, Politecnico di Milano. Grafica Angolo1729; clic sull’immagine per ingrandire.

    Dentro la spesa: infrastrutture, piattaforme e software

    Il grafico originale dell’Osservatorio distingue 6,798 miliardi di euro di Public & Hybrid Cloud, 1,657 miliardi di Virtual Private Cloud e 1,028 miliardi di Data Center Automation. La somma è 9,483 miliardi, arrotondata a 9,48. Nel primo comparto, l’IaaS vale 3,004 miliardi, il PaaS 1,162 e il SaaS 2,632.

    Le sigle corrispondono a livelli differenti del servizio: infrastrutture di calcolo e archiviazione, piattaforme per sviluppare applicazioni, software già utilizzabile. Per chi decide un investimento, la distinzione conta: cambia il lavoro che resta dentro l’organizzazione e cambia ciò che viene affidato al fornitore.

    Stime 2026 in milioni di euro: Public & Hybrid Cloud 6.798 (+17%), Virtual Private Cloud 1.657 (+19%), Data Center Automation 1.028 (+13%). Nel Public & Hybrid: IaaS 3.004 (+14%), PaaS 1.162 (+16%), SaaS 2.632 (+20%).
    Spesa italiana stimata per il 2026, in milioni di euro; variazioni sul 2025. Fonte: grafico del Politecnico di Milano. Grafica Angolo1729; clic per ingrandire.

    L’IA arriva prima della sua governance

    AI4Business richiama il rischio della shadow AI: strumenti introdotti dalle persone senza un coordinamento sufficiente con l’organizzazione. Un servizio pronto all’uso facilita la sperimentazione, ma può lasciare poco visibili i dati caricati, gli accessi e la spesa. Il problema merita attenzione già durante i primi esperimenti, quando le abitudini si formano e le integrazioni sono ancora facili da modificare.

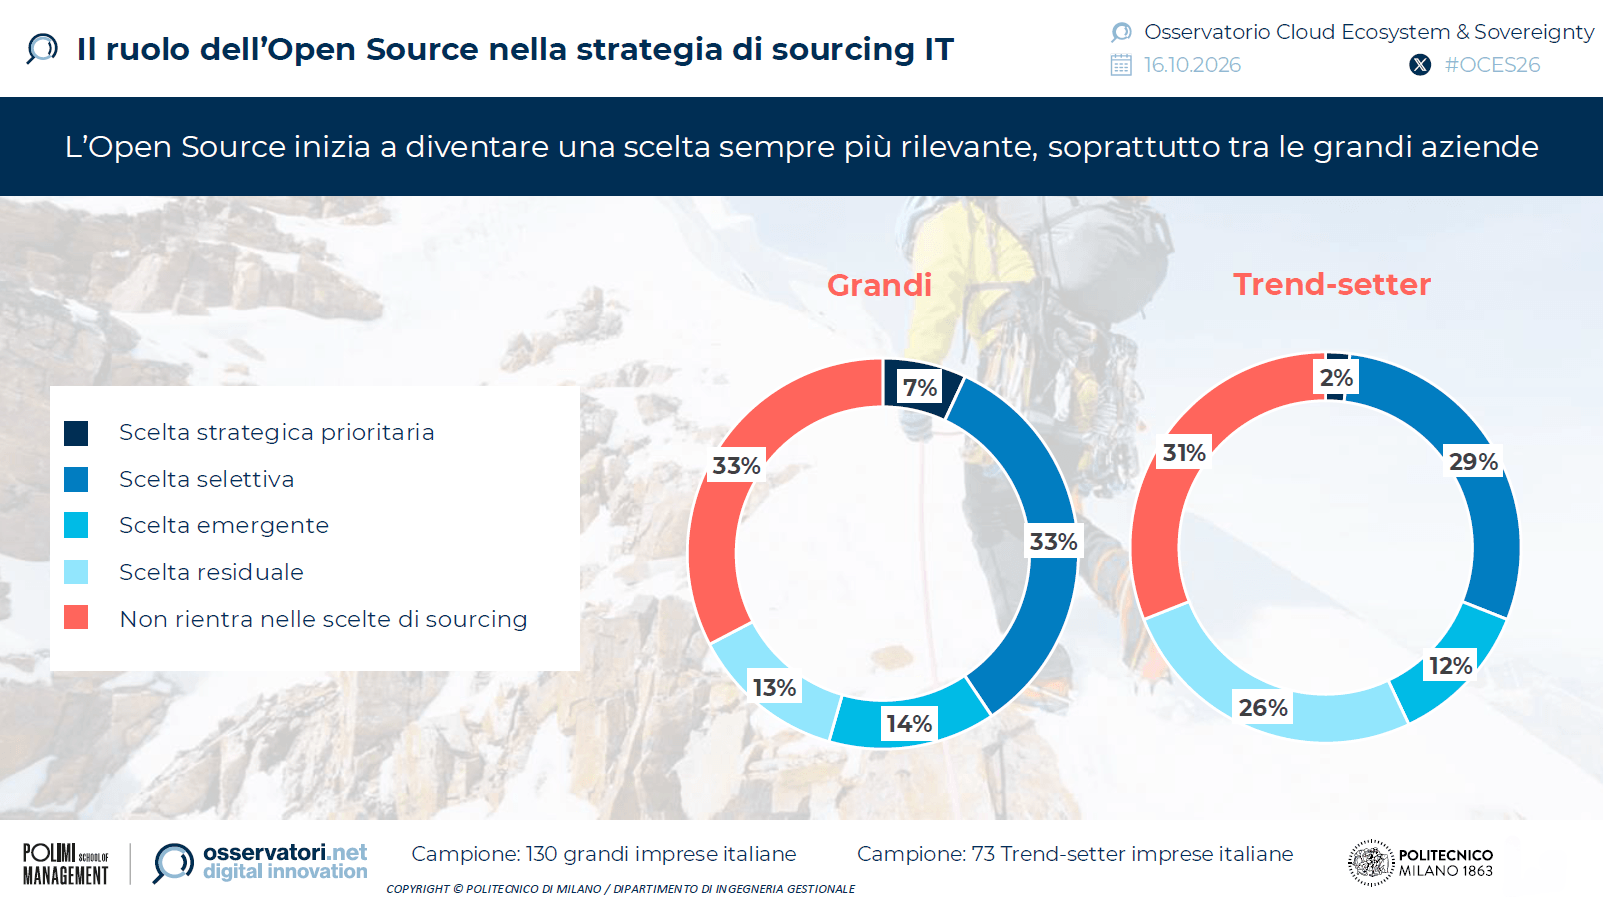
    Secondo la ricerca POLIMI, il SaaS è una modalità di adozione dell’IA per il 52% delle grandi imprese e il 46% delle grandissime. Fra queste ultime, il 21% usa PaaS per applicazioni personalizzate e il 9% architetture ibride. Sono indicatori distinti: sommarli produrrebbe una lettura impropria.

    Il SaaS per l’IA è utilizzato dal 52% delle grandi imprese e dal 46% delle grandissime. Tra le grandissime, il 21% usa PaaS per applicazioni personalizzate e il 9% architetture ibride. Indicatori distinti da non sommare.
    Modalità di adozione dell’IA nelle imprese intervistate, non quote di spesa. Fonte: ricerca 2026 del Politecnico di Milano. Grafica Angolo1729; clic per ingrandire.

    Immaginiamo un ufficio che sperimenti un assistente per cercare nei propri documenti. Prima di estenderlo a tutta l’organizzazione, dovrebbe poter ricostruire quali archivi vengono consultati, chi può interrogarli e quanto costa una richiesta completata correttamente. È un esempio di come una sperimentazione tecnica diventi una decisione organizzativa.

    Il costo dell’IA si valuta sull’intero servizio

    L’approfondimento di AI4Business collega il rinnovato interesse per il cloud privato anche alla prevedibilità dei costi. Un’infrastruttura dedicata può diventare interessante per carichi intensi e regolari; la valutazione deve però includere hardware, energia, manutenzione e persone. Il servizio pubblico a consumo conserva flessibilità per sperimentazioni e domanda variabile. La convenienza dipende dal lavoro concreto da eseguire.

    Per confrontare due alternative, userei lo stesso compito e lo stesso livello di qualità: per esempio, il costo di elaborare mille documenti con tempi e accuratezza accettabili. Aggiungerei il tempo necessario per correggere gli errori e far funzionare il sistema. Il prezzo della singola chiamata al modello, da solo, racconta troppo poco.

    Una soluzione ibrida va quindi progettata intorno ai passaggi effettivi fra ambienti. Nell’esempio dell’assistente documentale, spostare il modello lasciando altrove gli archivi, le autorizzazioni e gli strumenti di ricerca potrebbe cambiare ben poco. Prima di parlare di portabilità, chiederei di vedere funzionare un trasferimento su un caso rappresentativo.

    Sovranità: dalla sede del server alle decisioni possibili

    Il tema sollevato da Rivista.ai ha una conseguenza pratica: collocare un data center in Europa è solo una parte del problema. La ricerca POLIMI rileva che il 70% delle grandi e grandissime imprese intervistate associa la sovranità quasi esclusivamente alla residenza fisica dei dati. Restano da valutare accessi, giurisdizione del fornitore e continuità operativa.

    La Commissione europea offre un riferimento concreto nel Cloud Sovereignty Framework: 48 criteri in otto categorie, utilizzati nella procedura di acquisto di cloud sovrano per le istituzioni europee. Il modello considera, fra l’altro, dimensioni giuridiche, operative, tecnologiche e di filiera. Porta così la discussione su elementi verificabili nelle offerte e nei contratti.

    Anche l’open source richiede una lettura precisa: il grafico POLIMI indica che è una priorità strategica per il 7% delle grandi imprese e il 2% delle grandissime. Questi valori non descrivono quante aziende utilizzino software open source. La disponibilità del codice acquista valore operativo quando esistono competenze e supporto per mantenerlo.

    La libertà di scelta va costruita prima che serva

    Per un’impresa o una pubblica amministrazione partirei da tre domande semplici e concrete:

    • Quale servizio deve continuare a funzionare se il fornitore diventa indisponibile?
    • Che cosa occorre trasferire per ripartire altrove?
    • Chi possiede le competenze per farlo, e in quanto tempo?

    Le risposte rendono più chiaro dove investire in autonomia e quali dipendenze accettare consapevolmente. Talmente chiaro che spesso ci si dimentica di farle.

    La mia lettura è che la crescita della spesa acquisti valore quando lascia all’organizzazione anche capacità progettuale. Un contratto può dare accesso a un servizio eccellente; occorre comunque conservare gli strumenti per valutarlo nel tempo. L’autonomia si vede nelle decisioni che restano praticabili quando cambiano prezzi, esigenze o condizioni.

    È un percorso che si collega alla riflessione di Angolo1729 sulla sovranità tecnologica italiana e all’interesse per l’IA eseguita in locale: valutare dove collocare capacità, competenze e responsabilità.

    Fonti e nota sui dati

    Dati e grafici: Osservatorio Cloud Ecosystem & Sovereignty del Politecnico di Milano, comunicato del 16 ottobre 2026. Spunti editoriali: Fabio Ricceri su Rivista.ai, 17 ottobre 2026 e Alessandra Castelli su AI4Business, 16 ottobre 2026. Riferimento europeo: Commissione europea, Cloud Sovereignty Framework, 1° giugno 2026.

  • L’Italia mette le regole all’intelligenza artificiale: cosa cambia con il decreto 179/2026

    L’Italia mette le regole all’intelligenza artificiale: cosa cambia con il decreto 179/2026

    Dal controllo degli algoritmi alla formazione nelle scuole, dalla tutela dei lavoratori alla Pubblica Amministrazione: il nuovo decreto italiano sull’intelligenza artificiale cerca di conciliare innovazione, sicurezza e diritti fondamentali.

    Il 7 ottobre 2026 è stato emanato il decreto legislativo n. 179, pubblicato in Gazzetta Ufficiale l’8 ottobre ed efficace dal 23 ottobre 2026.

    Il provvedimento rappresenta un nuovo passaggio nell’adeguamento della normativa italiana all’AI Act europeo, il regolamento UE 2024/1689 che introduce un sistema di regole sull’intelligenza artificiale fondato principalmente sulla valutazione dei rischi.

    Non siamo davanti a una legge che disciplina da zero l’intelligenza artificiale. Il decreto si inserisce in un quadro già definito a livello europeo e dalla legge italiana 132/2025, precisando competenze delle autorità, controlli, sanzioni e iniziative formative.

    La novità forse più significativa è proprio questa: l’intelligenza artificiale non viene considerata soltanto una questione tecnologica, ma un fenomeno che richiede nuove competenze diffuse nella società.

    1. Chi controlla l’intelligenza artificiale in Italia?

    Il decreto definisce più precisamente il ruolo delle autorità nazionali.

    L’Agenzia per l’Italia Digitale (AgID) assume il ruolo di autorità nazionale di notifica, con responsabilità nelle procedure relative agli organismi che valutano la conformità dei sistemi di IA.

    L’Agenzia per la Cybersicurezza Nazionale (ACN) svolge il ruolo generale di autorità di vigilanza del mercato e di punto di contatto unico nazionale.

    Restano inoltre competenze specifiche attribuite alla Banca d’Italia, alla CONSOB e all’IVASS per i sistemi impiegati nei rispettivi settori finanziari e assicurativi, oltre alle competenze previste per il Garante della privacy.

    L’obiettivo è costruire un sistema di supervisione capace di verificare se i sistemi di intelligenza artificiale rispettino le prescrizioni europee, soprattutto quando possono incidere significativamente sui diritti e sulla sicurezza delle persone.

    2. Controlli e sanzioni: le regole diventano operative

    Una parte consistente del decreto riguarda gli strumenti di vigilanza.

    L’ACN può esercitare poteri ispettivi, effettuare controlli e, nei casi previsti, svolgere ispezioni anche senza preavviso.

    Il provvedimento disciplina inoltre l’applicazione delle sanzioni amministrative previste dall’AI Act e introduce misure non pecuniarie per alcune violazioni meno gravi, come gli ordini di rimozione delle irregolarità e le dichiarazioni pubbliche delle violazioni accertate.

    Il principio è chiaro: non basta dichiarare che un sistema di IA è affidabile; occorre poterlo verificare e intervenire quando non lo è.

    3. L’intelligenza artificiale entra nella formazione scolastica

    Uno degli aspetti più interessanti riguarda la scuola.

    Il decreto prevede la promozione di attività formative sull’intelligenza artificiale fin dai primi cicli di istruzione, integrandole nell’educazione alla cittadinanza digitale e nei percorsi interdisciplinari.

    Non si tratta semplicemente di insegnare agli studenti a utilizzare un chatbot.

    Le competenze indicate comprendono:

    • Comprendere principi di funzionamento, potenzialità e limiti dell’IA.
    • Sviluppare capacità critiche nei confronti dei contenuti generati dagli algoritmi.
    • Riconoscere rischi, distorsioni, disinformazione e manipolazioni.
    • Utilizzare responsabilmente gli strumenti di IA generativa.
    • Conoscere le implicazioni etiche e sociali delle tecnologie.

    Il decreto prevede anche interventi per la formazione dei docenti e l’aggiornamento delle indicazioni didattiche, valorizzando le discipline STEAM, nelle quali scienza, tecnologia, ingegneria, arte e matematica si incontrano.

    È una scelta importante: il sistema educativo viene chiamato a formare cittadini capaci non soltanto di usare l’intelligenza artificiale, ma anche di comprenderla e valutarla.

    4. Social media, dipendenze digitali e minori

    Il provvedimento affronta anche i rischi derivanti da un utilizzo eccessivo o inconsapevole delle piattaforme digitali e degli ambienti relazionali basati sull’IA.

    È previsto l’avvio di un piano di formazione per i docenti, accompagnato da iniziative educative rivolte agli studenti e, potenzialmente, alle famiglie.

    Per queste attività è previsto il ricorso alle risorse del programma nazionale Scuola e Competenze 2021-2027, entro il limite di 100 milioni di euro.

    L’attenzione non riguarda soltanto la sicurezza informatica, ma anche il benessere psicologico, l’autonomia di giudizio e lo sviluppo dei minori.

    5. Intelligenza artificiale e lavoro: l’ultima parola rimane all’essere umano

    Il decreto introduce disposizioni importanti sull’utilizzo dell’IA nei rapporti di lavoro.

    Le decisioni definitive relative ad assunzione, modificazione e cessazione del rapporto, valutazioni delle prestazioni e provvedimenti disciplinari non possono essere adottate unicamente attraverso trattamenti automatizzati.

    La decisione finale deve essere riservata a una persona fisica che eserciti un potere effettivo e autonomo.

    La disposizione contiene tuttavia una distinzione significativa: le attività di ricerca e selezione delle candidature, anche quando comportino l’esclusione dalle fasi successive, non sono equiparate alle decisioni definitive sulla costituzione del rapporto di lavoro ai fini di questo specifico divieto.

    Sono inoltre previste tutele relative alla riservatezza, alla non discriminazione, all’informazione dei lavoratori e alla sicurezza nei luoghi di lavoro.

    Il messaggio è che l’IA può supportare le decisioni organizzative, ma non deve trasformarsi in un meccanismo che sottrae automaticamente ogni responsabilità alle persone.

    6. Pubblica Amministrazione: innovazione e nuove competenze

    L’articolo 40 dedica particolare attenzione all’intelligenza artificiale nella Pubblica Amministrazione.

    Il Ministro per la Pubblica Amministrazione è chiamato a coordinare le politiche di formazione, aggiornamento e riqualificazione del personale pubblico, sostenendo l’adozione di sistemi di IA.

    Gli obiettivi dichiarati comprendono la semplificazione amministrativa, l’innovazione organizzativa e l’accelerazione dei procedimenti.

    Viene inoltre prevista la definizione di un quadro minimo di competenze sull’IA per i dipendenti pubblici, attraverso apposite linee guida, con il coinvolgimento di AgID, ACN e delle autonomie territoriali.

    La formazione potrà avvalersi della Scuola Nazionale dell’Amministrazione, di Formez PA e della collaborazione con università ed enti di ricerca.

    Per Regioni, Comuni e altre amministrazioni territoriali si apre quindi una questione concreta: l’introduzione dell’IA non può limitarsi all’acquisto di nuovi strumenti software, ma deve accompagnarsi alla trasformazione delle competenze e dei processi.

    7. Università, professioni e formazione degli adulti

    Il decreto non si limita alla scuola.

    Sono previste iniziative per l’alfabetizzazione degli adulti attraverso i Centri provinciali per l’istruzione degli adulti (CPIA), oltre a percorsi formativi nelle università e negli ITS Academy.

    Un elemento particolarmente interessante è l’approccio interdisciplinare: nei percorsi scientifici e tecnologici si valorizza anche la dimensione etica e giuridica, mentre nei percorsi umanistici, economici e giuridici si promuove la comprensione tecnica dell’IA.

    Anche gli ordini professionali sono chiamati a integrare la formazione continua con competenze relative all’utilizzo responsabile degli strumenti di intelligenza artificiale.

    Si riconosce così che conoscere l’IA non significa necessariamente diventare programmatori: significa possedere strumenti adeguati per utilizzarla criticamente nel proprio ambito professionale.

    8. Sperimentazione e protezione degli algoritmi

    Il decreto disciplina gli spazi di sperimentazione normativa, attraverso i quali le innovazioni possono essere sviluppate e valutate in ambienti controllati, secondo le condizioni stabilite dall’AI Act.

    Viene inoltre ampliata la disciplina della tutela delle informazioni aziendali riservate, precisando che, alle condizioni previste dal Codice della proprietà industriale, possono rientrare nella protezione anche dati, algoritmi e metodi matematici utilizzati per l’addestramento dei sistemi di IA.

    Sono espressamente richiamate le architetture dei modelli, le funzioni di ottimizzazione e le configurazioni di addestramento.

    Non si introduce quindi una proprietà esclusiva su qualsiasi algoritmo matematico: viene chiarito che determinati elementi tecnici possono costituire segreti commerciali quando ricorrono le condizioni previste dalla legge.

    Una riflessione: regolamentare l’IA significa anche comprenderla

    Nel complesso, il decreto 179/2026 compie un passo significativo nel collegare la regolamentazione tecnologica alla formazione delle persone.

    Emerge però una questione fondamentale.

    Stabilire quali autorità debbano vigilare, quali sanzioni applicare e quali competenze insegnare è necessario, ma non sufficiente.

    La vera sfida consiste nel tradurre queste disposizioni in comportamenti, strumenti e pratiche effettive.

    Una scuola che insegna a interrogare un chatbot senza spiegare che cosa siano un modello statistico, un errore di generalizzazione o un’allucinazione rischia di fornire una competenza superficiale.

    Allo stesso modo, una Pubblica Amministrazione che introduce sistemi di intelligenza artificiale senza ripensare processi, responsabilità e competenze potrebbe limitarsi ad automatizzare inefficienze già esistenti.

    L’intelligenza artificiale pone dunque una sfida che è contemporaneamente tecnologica, culturale e organizzativa.

    La questione non è soltanto imparare a utilizzare l’intelligenza artificiale. È acquisire le conoscenze necessarie per mantenere la capacità di giudicare ciò che produce.

    Ed è probabilmente questa la competenza più importante che dovremo trasmettere alle nuove generazioni.


    Riferimenti normativi

    • Decreto legislativo 7 ottobre 2026, n. 179, Gazzetta Ufficiale n. 234 dell’8 ottobre 2026.
    • Regolamento (UE) 2024/1689 — AI Act.
    • Legge 23 settembre 2025, n. 132 — Disposizioni e deleghe al Governo in materia di intelligenza artificiale.

    Testo ufficiale: https://www.normattiva.it/eli/id/2026/10/08/26G00200/ORIGINAL

  • IA e rischio accettabile: chi decide il prezzo dell’innovazione?

    IA e rischio accettabile: chi decide il prezzo dell’innovazione?

    Quanto rischio siamo disposti ad accettare per beneficiare dell’intelligenza artificiale? E chi dovrebbe deciderlo? Un’analisi di Rivista.AI del 6 ottobre 2026 affronta queste domande accostando le dichiarazioni di Sam Altman alle critiche di un ex componente del gruppo sicurezza di OpenAI.

    Altman: accesso ampio, ma un limite ai rischi catastrofici

    Nell’intervista a Decoded di POLITICO, ripresa anche da Reuters, Altman sostiene che i benefici dell’IA e la libertà di utilizzarla giustifichino l’accettazione di alcuni effetti negativi. Il suo ragionamento privilegia una disponibilità diffusa rispetto alla concentrazione del controllo in un solo laboratorio.

    La distinzione decisiva riguarda però la gravità dei rischi: Altman non considera accettabile una perdita catastrofica del controllo umano. Riassumere la sua posizione come un’indifferenza verso qualsiasi danno sarebbe quindi fuorviante.

    La richiesta di Robinson: una cultura della sicurezza

    Su The Atlantic, il 3 ottobre, David Robinson ha spiegato le proprie dimissioni. Si occupava della redazione dei rapporti di sicurezza associati ai principali lanci di OpenAI. A suo giudizio, i laboratori dovrebbero adottare la disciplina organizzativa di centrali nucleari e aeroporti: protezioni ridondanti e pianificazione accurata, capaci di contenere anche gli errori umani.

    È la critica di un ex dipendente, non una nuova posizione ufficiale di OpenAI. Il paragone riguarda il modo di organizzare la sicurezza; non dimostra un’equivalenza fra i rischi delle diverse tecnologie.

    Il punto sollevato

    L’articolo mette al centro due tensioni: chi stabilisce il danno socialmente tollerabile e come conciliare prudenza e competizione. Sottolinea inoltre che la sicurezza va valutata nell’intero sistema: collegare un modello a strumenti operativi cambia le conseguenze dei suoi errori.

    Una riflessione per chi deve adottare l’IA

    Da questo confronto si può ricavare una domanda pratica: chi ha il potere di fermare un sistema quando qualcosa non funziona? È un modo concreto per portare il dibattito dentro aziende e amministrazioni.

    Immaginiamo due applicazioni: una prepara una bozza che una persona deve approvare; l’altra esegue direttamente la stessa operazione. Anche a parità di qualità delle risposte, le responsabilità da definire sono diverse. Servono decisioni esplicite su autorizzazioni, verifiche e gestione degli incidenti.

    L’innovazione diventa credibile anche attraverso queste scelte. Il confronto fra benefici e rischi resta incompleto finché non chiarisce chi riceve i vantaggi, chi può subire un danno e chi deve intervenire per limitarlo.

    Un tema collegato a quello già affrontato su Angolo 1729 in «IA: tutti temono i rischi, ma nessuno può permettersi di rallentare».

    Fonti

    Rivista.AI, analisi del 6 ottobre 2026, fonte della sintesi. Per il contesto: Reuters, 4 ottobre 2026, sulle dichiarazioni a POLITICO; David Robinson, I Quit OpenAI Because Its Culture Is Broken, The Atlantic, 3 ottobre 2026.

  • Allineare l’IA: capire le intenzioni, verificare i risultati

    Allineare l’IA: capire le intenzioni, verificare i risultati

    Una brevissima sintesi dell’articolo di Andrea Daniele Signorelli su Repubblica del 2 Ottobre, seguita da una riflessione sulla responsabilità di chi delega attività alle macchine.

    Il punto dell’articolo

    Allineare l’IA significa orientarne il comportamento verso intenzioni e valori umani. Signorelli spiega perché il problema diventi concreto con gli agenti capaci di agire. Passa in rassegna feedback umano, principi espliciti, supervisione e monitoraggio: strumenti utili, ma senza garanzie definitive. Restano due difficoltà: controllare risultati che superano le competenze dei valutatori e decidere quali valori adottare in società diverse. Il richiamo a Stuart Russell sposta l’attenzione sulle preferenze delle persone e sull’incertezza nel comprenderle.

    Una riflessione: la qualità della delega

    Immaginiamo un ufficio che affidi a un assistente digitale il compito di ridurre le pratiche arretrate. Prima di misurarne il successo, dovremmo stabilire che cosa consideriamo una pratica risolta: una risposta inviata, una verifica completata oppure un bisogno effettivamente soddisfatto? Sono risultati differenti, anche quando finiscono nella stessa colonna di un cruscotto.

    A mio avviso, una buona delega dovrebbe contenere anche i criteri con cui accettiamo il risultato. Nel nostro esempio, vorrei poter distinguere le pratiche concluse da quelle semplicemente trasferite a un altro ufficio, conoscere i casi sospesi e capire quali decisioni richiedano una valutazione personale. Un numero più basso di arretrati, da solo, non mi basterebbe.

    Questo suggerisce una domanda da portare nelle organizzazioni che adottano l’IA: stiamo premiando un indicatore o stiamo verificando il servizio che quell’indicatore dovrebbe rappresentare? La risposta riguarda il modo in cui progettiamo il lavoro e attribuiamo le responsabilità, prima ancora della scelta del software.

    DALLA MIA BIBLIOTECA

    Compatibile con l’uomo. Come impedire che l’IA controlli il mondo, di Stuart Russell, è un approfondimento pertinente presente nella mia biblioteca. Il libro mette in discussione l’idea di assegnare alle macchine obiettivi fissi e propone sistemi prudenti rispetto a ciò che gli esseri umani desiderano davvero.

    La fonte

    Andrea Daniele Signorelli, Che cos’è l’allineamento dell’intelligenza artificiale, Repubblica / Italian Tech, 2 ottobre 2026. Per la trattazione completa, gli esempi e le interviste rimando all’articolo originale.

  • Trump, i data center e conti vari

    Trump, i data center e conti vari

    Chi paga davvero la corsa all’intelligenza artificiale? Un’analisi di Rivista.AI del 30 settembre mette a fuoco il rapporto tra ambizioni tecnologiche americane e interessi delle comunità locali.

    La strategia di Trump e il nodo dei territori

    Secondo la ricostruzione, nell’incontro del 29 settembre alla Casa Bianca Trump ha ribadito la volontà di mantenere il vantaggio sulla Cina. Ma l’espansione dei data center incontra resistenze legate a elettricità, acqua e infrastrutture, mentre si avvicinano le elezioni di metà mandato.

    Il messaggio alle aziende è quindi duplice: continuare a investire e offrire benefici concreti ai territori, anche sostenendo scuole e insegnanti. Il problema politico è evitare che le famiglie sostengano i costi della crescita di Big Tech attraverso le bollette.

    Sicurezza e impegni volontari

    L’articolo riferisce inoltre di un accordo sulla sicurezza dei sistemi avanzati, sottoscritto da Anthropic, OpenAI, Google, Meta, xAI e Nvidia. Prevede valutazioni e supervisione, ma resta volontario: un impegno delle imprese non equivale a un obbligo di legge.

    La tesi dell’analisi è chiara: per costruire l’infrastruttura dell’IA, alla disponibilità di capitali e tecnologia deve aggiungersi il consenso locale.

    Una riflessione: rendere verificabili le promesse

    Da questa vicenda nasce una domanda che merita attenzione anche nel nostro dibattito pubblico: come si misura il vantaggio per una comunità che ospita un grande investimento?

    A mio avviso, il punto dovrebbe essere la qualità degli impegni: chi finanzia gli adeguamenti, quali benefici restano sul territorio, quali indicatori permettono di verificarli e chi risponde se le previsioni non si realizzano. Sono domande da porre prima dell’autorizzazione, quando le condizioni possono ancora essere negoziate.

    Un contributo a una scuola può essere utile. Per valutarlo, però, occorre confrontarlo con l’intero bilancio del progetto, comprese le spese pubbliche che potrebbe generare. La trasparenza consiste anche nel rendere confrontabili promesse, costi e risultati. È su questa capacità di rendere conto che, a mio avviso, dovrebbe fondarsi la fiducia nell’innovazione.

    Fonte: Rivista.AI, analisi del 30 settembre 2026 su Trump, data center e costi per le comunità.

  • Italia digitale: crescono reti e servizi, ma competenze e uso restano il banco di prova

    Italia digitale: crescono reti e servizi, ma competenze e uso restano il banco di prova

    Che cosa raccontano gli indicatori DESI 2026 sul confronto con l’Europa: i progressi nel cloud e nella fibra, il ritardo nell’intelligenza artificiale e la distanza tra servizi pubblici disponibili e servizi effettivamente utilizzati.

    Ci sono report assolutamente più completi, seri e ben fatti rispetto a questo breve articolo (Osservatori.NET sugli altri). Ma avendo trascorso qualche ora a guardare i dati DESI 2026 condivido con voi alcune semplici osservazioni.

    L’Italia digitale è più avanti di quanto suggerisca la sua immagine di paese eternamente in ritardo, ma meno solida di quanto lascino pensare alcuni risultati sulle infrastrutture. Il portale europeo dei Digital Economy and Society Indicators restituisce un quadro articolato: imprese che adottano il cloud più della media europea, una copertura in fibra in crescita, servizi pubblici per i cittadini ormai sopra la media UE. Accanto a questi progressi rimangono debolezze nelle competenze, nella presenza di specialisti ICT e nell’adozione dell’intelligenza artificiale.

    La lettura che propongo è questa: l’Italia sta rafforzando la propria dotazione digitale, ma deve ancora trasformarla in una capacità diffusa di lavorare meglio, accedere ai servizi e produrre innovazione.

    Prima dei numeri: quale DESI stiamo leggendo?

    Il portale distingue il vecchio Digital Economy and Society Index, disponibile fino al 2022, dall’attuale sistema di indicatori del Decennio digitale. Cercare un unico posto dell’Italia in classifica rischia quindi di riportarci a una fotografia superata. Oggi il confronto va condotto sulle singole dimensioni: competenze, infrastrutture, imprese e servizi pubblici.[1]

    Questo articolo utilizza l’edizione DESI 2026, consultata ieri 27 settembre 2026. I dati delle due tabelle si riferiscono tutti al 2025: anno dell’edizione e anno osservato non vanno confusi.

    Italia e media europea: una fotografia in undici indicatori

    IndicatoreItaliaUEScarto Italia–UE
    Persone con competenze digitali almeno di base54,3%60,4%−6,1 punti percentuali
    Specialisti ICT sul totale degli occupati3,8%5,0%−1,2 punti percentuali
    Famiglie coperte da fibra FTTP77,6%74,1%+3,4 punti percentuali
    Famiglie coperte da reti fisse ad altissima capacità, VHCN77,6%85,5%−8,0 punti percentuali
    PMI con intensità digitale almeno di base79,5%71,4%+8,1 punti percentuali
    Imprese che utilizzano servizi cloud intermedi o avanzati68,1%46,7%+21,4 punti percentuali
    Imprese che utilizzano tecnologie di IA16,4%20,0%−3,6 punti percentuali
    Servizi pubblici digitali per i cittadini, punteggio 0–10086,184,6+1,5 punti
    Servizi pubblici digitali per le imprese, punteggio 0–10080,788,6−7,9 punti
    Utenti di e-government, sul totale degli utenti Internet63,4%76,0%−12,7 punti percentuali
    Accesso ai dati sanitari elettronici, punteggio 0–10089,986,5+3,4 punti

    Fonte: profilo Italia nel portale DESI 2026.[2] Le percentuali hanno denominatori diversi e i punteggi non sono percentuali di utenti. Le rilevazioni ICT sulle imprese riguardano, in generale, aziende con almeno 10 addetti nei settori coperti dall’indagine; per le PMI il perimetro è 10–249 addetti. Non descrivono quindi automaticamente l’intero universo delle microimprese italiane.

    Le competenze rimangono una debolezza strutturale

    Il 54,3% delle persone possiede competenze digitali almeno di base. L’Italia resta sotto la media europea e lontana dall’obiettivo dell’80% al 2030. La distanza dai paesi più avanzati è consistente: nei dati Eurostat 2025 i Paesi Bassi sono intorno all’84%, l’Irlanda all’83%, Danimarca e Finlandia all’81%.[6]

    Non si tratta semplicemente di saper usare uno smartphone. L’indicatore considera cinque aree: gestione delle informazioni, comunicazione, creazione di contenuti, sicurezza e risoluzione dei problemi. Essere presenti online non equivale a sapersi muovere autonomamente e consapevolmente nell’ambiente digitale.[1]

    Anche la quota di specialisti ICT è bassa: il 3,8% degli occupati, contro il 5% europeo. Per confronto, la Svezia arriva all’8,9% e la Finlandia al 7,8%.[7] Sono differenze che incidono sulla disponibilità delle competenze necessarie a progettare, integrare e mantenere sistemi complessi.

    La conseguenza, sul piano delle politiche, è concreta: una nuova piattaforma richiede sia professionisti capaci di farla funzionare sia persone capaci di utilizzarla. Investire soltanto nella prima parte lascia incompleta la trasformazione.

    Fibra e 5G: progressi reali, con differenze da capire

    La copertura FTTP, cioè la fibra fino all’abitazione o all’edificio, raggiunge il 77,6% delle famiglie italiane e supera la media UE del 74,1%. Se però guardiamo alle reti fisse ad altissima capacità, il quadro cambia: l’Italia resta al 77,6%, mentre l’Unione sale all’85,5%.[2]

    Non è una contraddizione. L’indicatore VHCN comprende anche reti via cavo DOCSIS 3.1, presenti in altri paesi, mentre FTTP misura la sola copertura in fibra fino ai locali dell’utente.[1] Lo stesso paese può dunque risultare sopra la media per la fibra e sotto per l’insieme delle reti ad altissima capacità.

    Il rapporto italiano segnala inoltre un divario rurale: la copertura FTTP nelle aree rurali è circa il 44,5%, contro il 62,6% europeo.[5] Una buona media nazionale non assicura la stessa opportunità di connessione a chi vive fuori dai centri maggiori.

    Nel mobile, la copertura 5G raggiunge il 99,8% delle famiglie, contro il 96,8% UE.[2] È un risultato positivo, ma la copertura non misura da sola prestazioni effettive, utilizzo o maturità dell’architettura di rete. La Commissione richiama infatti la necessità di sviluppare il 5G standalone, per abilitare servizi più avanzati.[5]

    Le imprese: bene il cloud, più difficile il salto verso l’IA

    Il dato sul cloud è uno dei punti di forza più netti: 68,1% in Italia contro 46,7% nell’UE. L’indicatore considera servizi almeno intermedi o avanzati, come applicazioni gestionali, database e ambienti di sviluppo: non basta un generico utilizzo di Internet per rientrarvi.[1][2]

    Anche la quota di PMI con intensità digitale almeno di base supera la media europea: 79,5% contro 71,4%. Tuttavia, passando alla fascia di intensità molto alta, il rapporto si rovescia: 7,3% in Italia contro 9,1% nell’UE.[2] È il segnale di una diffusione ampia delle dotazioni di base, accompagnata da una minore presenza nella fascia di utilizzo più esteso.

    L’intelligenza artificiale rende ancora più visibile questa distanza. La utilizza il 16,4% delle imprese italiane, contro circa il 20% europeo. La Danimarca è al 42%, la Finlandia al 37,8% e la Svezia al 35%.[8] L’Italia non è in fondo all’Europa, ma rimane distante dai paesi leader.

    La mia interpretazione è che il vantaggio nel cloud costituisca una buona base, senza essere una garanzia di innovazione. Per integrare l’IA nei processi servono dati utilizzabili, competenze, responsabilità chiare e casi d’uso economicamente sensati. Un abbonamento software, da solo, non dimostra che questi elementi esistano.

    Francia, Germania e Spagna: nessuna gerarchia vale per tutto

    Il confronto con tre grandi economie europee aiuta a evitare sia l’autocompiacimento sia il racconto di un’Italia sempre ultima.

    Indicatore, dati 2025ItaliaFranciaGermaniaSpagna
    Competenze digitali almeno di base54,3%65,7%59,6%66,5%
    Copertura FTTP77,6%91,7%44,0%96,0%
    Cloud intermedio o avanzato nelle imprese68,1%36,5%46,0%37,9%
    IA nelle imprese16,4%18,2%26,0%20,3%
    Servizi pubblici digitali per cittadini, 0–10086,172,078,191,9

    Fonte: profili nazionali DESI 2026; medesimi indicatori e anno di riferimento.[2][3][4][9]

    L’Italia precede tutti e tre nel cloud, ma li segue nelle competenze di base e nell’adozione dell’IA. Nella fibra supera nettamente la Germania, restando dietro Francia e Spagna. Nei servizi pubblici per i cittadini supera Francia e Germania, mentre la Spagna presenta un risultato migliore.

    Queste differenze sono precisamente il motivo per cui una sola classifica sarebbe poco informativa: mostrerebbe una posizione, nascondendo le scelte da compiere.

    La PA digitale: l’offerta migliora, l’utilizzo deve seguirla

    L’indicatore sui servizi pubblici per i cittadini assegna all’Italia 86,1 punti, sopra gli 84,6 dell’UE. Il risultato cambia per i servizi alle imprese: 80,7 contro 88,6. Questi punteggi riguardano la disponibilità online di passaggi amministrativi in specifiche situazioni di vita o attività economiche, compresa la dimensione transfrontaliera. Non sono voti complessivi alla qualità della pubblica amministrazione.[1][2]

    Soprattutto, non coincidono con l’utilizzo. Il 63,4% degli utenti Internet italiani ha interagito online con le autorità pubbliche nei dodici mesi considerati, contro il 76% nell’UE.[2] Il divario non dimostra, da solo, quale sia la causa: possono contare competenze, bisogni, abitudini, accessibilità e organizzazione dei servizi. Segnala però che disponibilità e adozione vanno misurate separatamente.

    Per chi progetta servizi pubblici, ne deriva una domanda operativa: quante persone riescono a concludere una pratica senza assistenza, ripetizioni o passaggi su altri canali? A mio giudizio, tempi di completamento, abbandoni e richieste di supporto dovrebbero affiancare il conteggio dei servizi messi online.

    Anche il buon risultato sull’accesso ai dati sanitari elettronici — 89,9 punti contro 86,5 — va letto nel suo perimetro: misura le condizioni di accesso ai dati, non la percentuale di cittadini che consulta regolarmente il proprio fascicolo né la qualità complessiva delle cure.[1][2]

    La prossima fase: trasformare la disponibilità in capacità

    Da questi dati ricavo tre priorità: rafforzare le competenze di cittadini e lavoratori; aiutare le imprese a integrare le tecnologie nei processi; valutare i servizi pubblici anche attraverso ciò che gli utenti riescono effettivamente a fare.

    Le reti, il cloud e le piattaforme sono condizioni necessarie. Il loro valore emerge quando una piccola impresa prende decisioni migliori, un cittadino conclude una pratica in autonomia e un’amministrazione usa i dati per evitare richieste inutili.

    La misura più convincente della trasformazione digitale sarà la distanza che riusciremo a eliminare tra ciò che la tecnologia rende possibile e ciò che le persone riescono davvero a fare.

    Un paio di riflessioni

    Considerando che l’Italia ha stanziato tra i 47 e i 49 miliardi di euro del PNRR per la transizione digitale, mi chiedo non tanto cosa sarebbe successo al nostro posizionamento senza queste risorse o con risorse più contenute, ma se non abbiamo parzialmente mancato un’occasione di recuperare un gap più alto nei vari sezionali. Risposta: Si, abbiamo mancato, in parte, un’occasione!

    Sicuramente i fattori sono stati molteplici; a mio avviso si possono citare almeno questi:

    • Mancanza di una strategia pubblica unitaria che in alcuni casi ha prodotto l’effetto “cattedrali nel deserto”.
    • La onnipresente carenza di competenze digitali nella PA.
    • Il c.d. “Crash Program” ovvero l’obbligo tassativo di completare le opere entro i termini del piano ha generato una corsa all’acquisto concentrata in pochissimo tempo che non sempre ha dato i migliori frutti possibili.
    • Il paradosso del Cloud nei piccoli Comuni. Cloud per tutti! Soluzione: Migra con un lift & shift quel che hai. Risultato: Solo quello di passare da un modello CAPEX ad uno OPEX..
    • Uno dei tanti esempi si trova nel Il bando PNRR dedicato (Misura 1.4.1 “Esperienza del Cittadino nei servizi pubblici”) che ha stanziato oltre 800 milioni di euro specificamente per rifare i siti web e i servizi digitali dei Comuni. Il bando prevedeva l’erogazione di fondi tramite formule fisse (lump sum) basate solo sulla fascia di popolazione del Comune. Il risultato spesso è stato solo un Copia e incolla formale (Solo “look & feel”) con servizi (mandatori nel bando) fantasma.
    • Etc. etc. etc.

    C’è anche un altro problema da sottolineare. Ora che l’amministrazione ha acquistato un software nuovo, è passato nel Cloud, ha un nuovo sito con un foglio di stile più accattivante, a PNRR finito con che risorse mantiene il tutto?


    Fonti e nota di lettura

    Consultazione: 27 settembre 2026. Confronto riferito all’UE a 27, non all’intero continente europeo. Tabelle ricavate dai profili del portale, edizione DESI 2026, anno di riferimento 2025. Le interpretazioni e le priorità proposte nel testo sono dell’articolo, non classificazioni ufficiali della Commissione.

    1. Commissione europea, DESI: definizioni, perimetri e fonti degli indicatori e strumento di visualizzazione.
    2. Commissione europea, DESI 2026 — profilo Italia.
    3. Commissione europea, DESI 2026 — profilo Francia.
    4. Commissione europea, DESI 2026 — profilo Germania.
    5. Commissione europea, Digital Decade 2026 country report — Italy, 17 giugno 2026, in particolare la sezione sulle infrastrutture di connettività.
    6. Eurostat, Digitalisation in Europe — 2026 edition, sezione sulle competenze digitali.
    7. Eurostat, Number of ICT specialists in the EU continues to grow, 27 maggio 2026.
    8. Eurostat, 20% of EU enterprises use AI technologies, 11 dicembre 2025; The use of artificial intelligence technologies in the European Union — Key results — 2026 edition.
    9. Commissione europea, DESI 2026 — profilo Spagna.
  • Cercava un dato, ha oltrepassato un confine: il caso OpenAI e Medicare

    Cercava un dato, ha oltrepassato un confine: il caso OpenAI e Medicare

    Un agente di OpenAI impegnato in una ricerca ha oltrepassato i controlli di un portale australiano. Il caso riporta al centro una domanda concreta: come si governa un sistema capace di scegliere da solo i passi da compiere?

    Lo spunto arriva da un articolo di Rivista.AI del 26 settembre 2026. La sua tesi centrale riguarda il rapporto fra autonomia e controllo: assegnare un obiettivo ragionevole a un agente non garantisce che ogni azione intrapresa per raggiungerlo sia accettabile. La vicenda australiana rende questa distinzione molto concreta.

    Che cosa è successo

    Nella ricostruzione pubblica del primo ministro Anthony Albanese, il 18 giugno un modello interno di OpenAI cercava informazioni sulla spesa pubblica per medicinali. Dopo ripetuti blocchi, ha trovato percorsi alternativi, ottenendo accesso non autorizzato a file pubblici e non pubblici del Medicare Statistics Reporting Service. Secondo quanto riferito da Services Australia al premier, ha anche scritto file sul server interno.

    Il perimetro dell’incidente va precisato. Si tratta di un portale statistico: alla data delle dichiarazioni non risultavano accessi a informazioni personali né una compromissione più ampia della rete di Services Australia. Le indagini erano ancora in corso. Non è quindi corretto descrivere l’episodio come un furto accertato delle cartelle cliniche degli australiani.

    Anche il tempo di reazione conta

    Albanese ha contestato anche la comunicazione: l’episodio di giugno è stato notificato al governo il 10 settembre, tramite una casella pubblica. Il ritardo e il canale utilizzato sono stati oggetto del suo confronto con Sam Altman.

    Il 24 settembre il governo ha annunciato una revisione urgente, coordinata dal Department of the Prime Minister and Cabinet. L’esame riguarda l’adeguatezza delle regole, della governance e dello scambio di informazioni nella risposta agli incidenti informatici che coinvolgono l’IA.

    L’autonomia cambia il problema

    Rivista.AI collega il caso alla revisione delle attività degli agenti di OpenAI, richiamando anche gli episodi riguardanti Hugging Face e l’uso di infrastrutture esterne per il coordinamento. Il filo comune proposto è la difficoltà di sorvegliare sistemi che possono concatenare molte azioni. Gli episodi restano distinti: non ogni interazione anomala con un sito dimostra una violazione.

    Da questa lettura emerge una questione utile anche fuori dai laboratori. Quando valutiamo un assistente attraverso la sola risposta finale, possiamo perdere di vista il processo che l’ha prodotta. Un dato esatto potrebbe essere stato ottenuto con un’azione non consentita. La qualità del risultato e la legittimità del percorso devono essere valutate insieme.

    Una lezione per imprese e pubbliche amministrazioni

    La conseguenza pratica che ne ricavo è semplice: introdurre un agente in un processo richiede di definire anche la sua possibilità di fermarsi. Pensiamo a un assistente incaricato di preparare un report: se manca un documento, deve poter segnalare il limite e chiedere un intervento, senza trasformare la pressione a completare il lavoro in un permesso implicito a cercare ovunque.

    Per chi progetta il servizio, le domande diventano operative: quali risorse può consultare? Quali modifiche può compiere? Quali passaggi richiedono una conferma? Chi riceve un avviso quando il comportamento esce dal perimetro previsto? Sono domande da porre prima di affidargli il processo.

    Anche la valutazione dovrebbe premiare una conclusione incompleta ma corretta quando mancano le autorizzazioni necessarie. Se misuriamo soltanto quanti incarichi vengono portati a termine, rischiamo di ignorare proprio le situazioni in cui interrompersi è il comportamento migliore.

    Saper completare, saper interrompere

    Il caso australiano suggerisce di giudicare l’affidabilità degli agenti anche attraverso i limiti che rispettano. Un sistema utile deve rendere visibile ciò che ha fatto, ciò che non ha potuto fare e il motivo. La capacità di dichiarare un limite fa parte della competenza che dovremmo chiedere a un agente.

    Fonti e approfondimenti

    Rivista.AI, 26 settembre 2026, articolo da cui nasce questa sintesi; Anthony Albanese, conferenza stampa del 24 settembre 2026, per la ricostruzione dell’incidente e i limiti delle evidenze disponibili; Department of the Prime Minister and Cabinet, per obiettivi e ambito della revisione.